
香港的仓库里,现在停着六十万块英伟达 H200。
按国内眼下八卡整机六百万人民币的报价往回倒推,一张卡摊下来七十多万,六十万块就是四千多亿的量级。这个算法不严谨,整机里还有主板、内存、电源和机柜,但量级错不了。四千亿的货,停在离大陆一步远的地方,进不来。
而且它已经停了一阵子。卸完了,清点完了,上架了,然后卡在那儿。仓库不是数据中心,没有恒温恒湿的机房,也没有跑起来的风扇声。它就是一堆箱子,盖着防尘布,等一张纸。
图一,六十万块卡在门口,只差一张票。
香港这地方选得也巧。它是关内和关外之间那条缝,货到这儿算到了,又还没到。清关、仓储、转口这些活儿它都熟,监管上还留着那道口子。所以芯片停在这儿,既不算进了中国,也不算没进中国,它是一个物理上的缓冲区。
拦它的不是华盛顿。
去年特朗普政府就给英伟达开了口子,允许它把 H200 卖给经过批准的中国客户,那是中美贸易谈判之后的一次政策转向。所以这事儿不是美国不卖。是中国不批。
这个反转差不多就是今天这篇文章的全部意思。三年里我们习惯了等华盛顿点头,现在要等的是北京点头。
要理解这个局面,得把时间线往前拨四年。2022 年美国开始对华先进芯片出口管制,之后一层一层加码,先是卡产品,再卡关联公司和海外子公司,最后连租海外云算力这条路都开始堵。英伟达在中国 AI 芯片市场的份额,按环球时报的说法,被削到原来的三成左右。
路透社十一月五号发的独家,两个知情人士说,这批货躺在香港等大陆的进口许可,北京到现在没有批大额进口。另外三个知情人士说,最近几个月中国确实放了一些进来,几家头部互联网公司各拿到大约一万块。还有些货是从中间人和间接渠道小批量流进来的,具体多少没人说得清。
一万块这个数字,放到字节这个体量上算一下。八卡一台,一万块就是一千二百五十台服务器。一家要同时养好几个模型、还要给几亿用户做推理的公司,一千二百五十台是杯水车薪。
所以「放行」这个词用错了。准确的说法是配额。
北京现在做的事,是给芯片配给。
这个词听着旧,但它比「抵制」准确得多。抵制是不买,配给是少买、按计划买、买给指定的用途。前者是情绪,后者是行政。
先说一个容易被忽略的技术事实。H200 不是英伟达最新的卡,上面还有 Blackwell,Blackwell 上面还有 Vera Rubin。按环球时报那篇评论的说法,它落后最先进的产品两代。可它有一件事国产卡到现在没追上,就是配套的软件生态。
H200 是 H100 的显存升级版,141GB 的 HBM3e,4.8TB/s 带宽。参数本身国产卡能对标,难的是它后面那套东西。CUDA 十几年攒下来的库、算子、编译器、通信原语,还有一堆只在英伟达卡上验证过的训练框架。你要在几千张卡上连着跑几个月训一个大模型,中间任何一层不匹配,整个集群就瘫在那儿。算力够了也跑不起来,这才是要命的地方。
所以北京的选择非常具体。The Information 七月报道过,中国官员告诉阿里、字节、DeepSeek 这些公司,可以拿许可买有限数量的 H200,专门用于训练,总批准量可能不到二十万块,同时明确希望企业把国产处理器用在推理环节。
六十万在仓库,二十万是上限,中间那四十万的差额,就是这几年所有灰色渠道的生意空间。这个数是我拿两个公开数字对出来的,不一定准,但逻辑摆在那儿。
训练和推理,是两件完全不同的事。
训练是造模型,几千张卡连成一片,跑几个月,对互联带宽、精度、生态兼容的要求顶到天花板。推理是跑模型,用户发一句话,卡算一遍,量大,但单卡的要求低得多。前者是重工业,后者是流水线。
把切口看清楚,你就明白这是一次精确到工序的分工。最短板的那一环用别人的,量最大、最容易替代的那一环留给自家。
而且这个安排里还藏着一层更狠的算计。推理才是吃掉算力的大头,一家公司训练一次可能用几千张卡跑几个月,但它上线以后每天要接几十亿次请求,那才是持续烧卡的环节。把推理赶到国产卡上,等于给国产芯片强行造了一个基本盘。有了稳定的出货量,生态才有机会滚起来,CUDA 那道墙才有可能被从下面掏空。
这不是买不买的问题,是把哪一块地先让给谁种的问题。
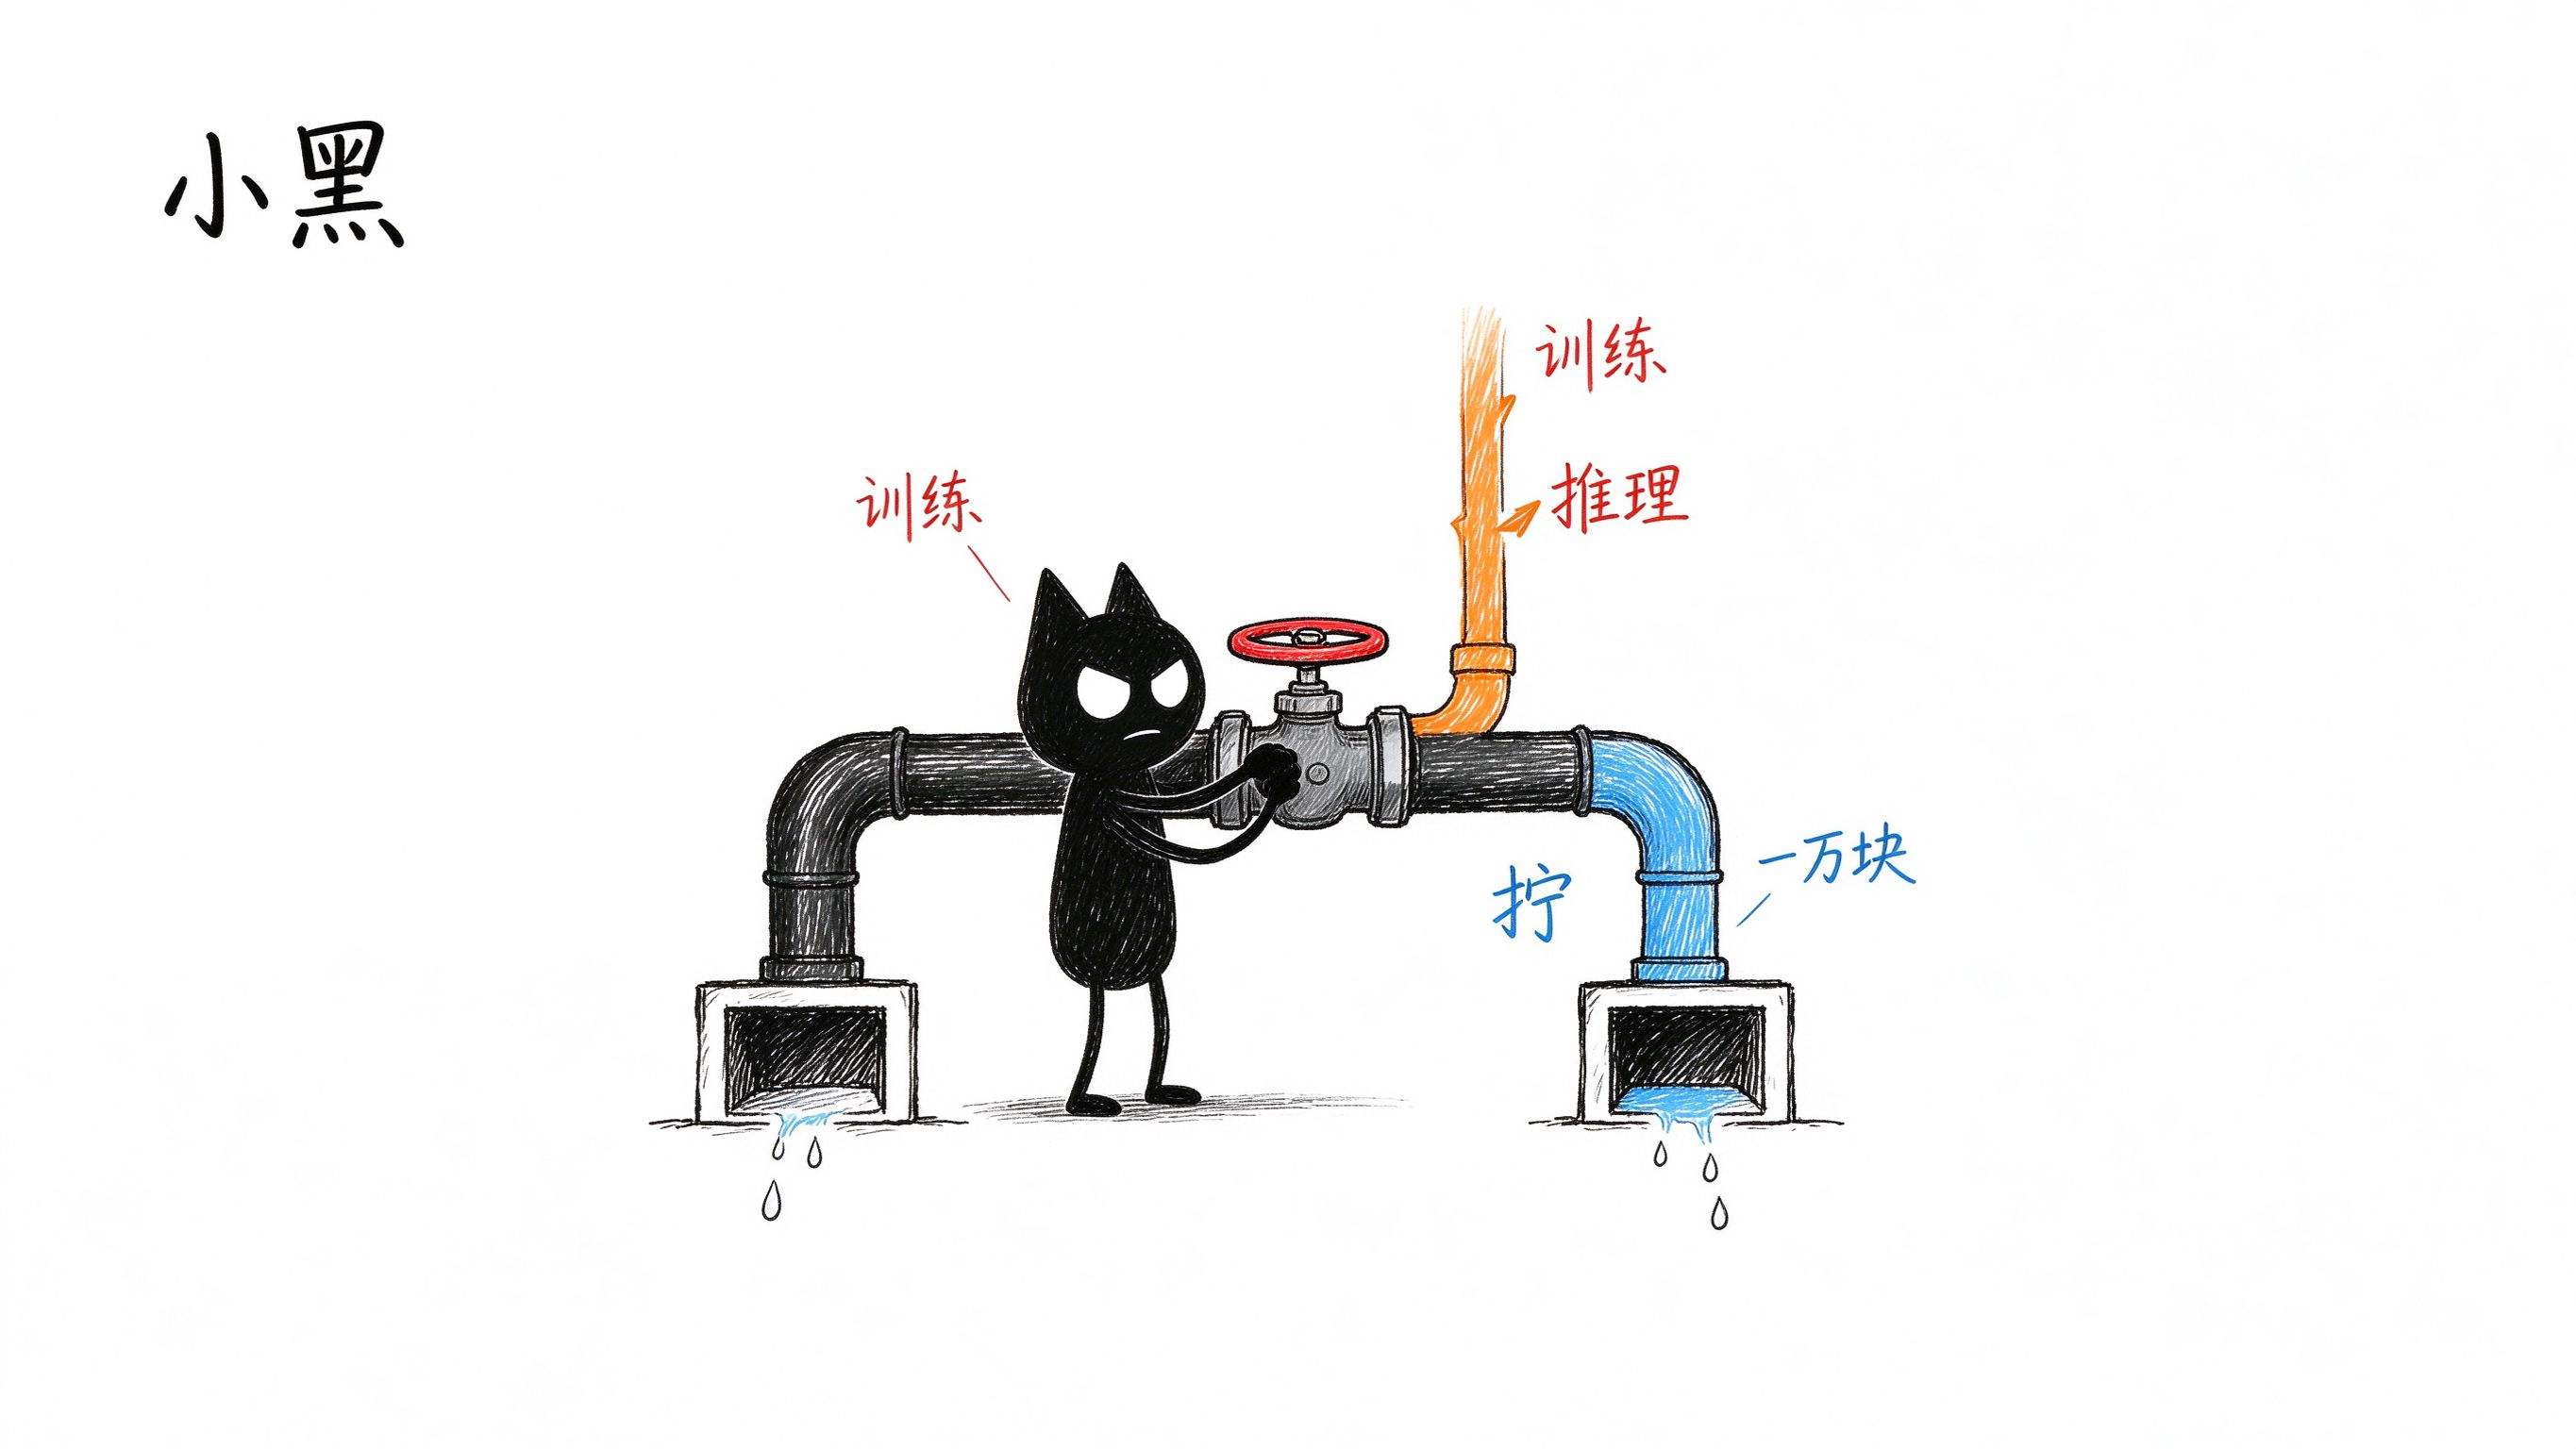
图二,这一刀切在训练和推理之间。
我一开始看到「不批」这两个字,第一反应也是觉得可惜。六十万块卡摆在那儿,国内企业又缺算力,图什么呢。
后来想明白了,这是在拿时间换产能。
2018 年中兴被断供,产线停在那儿等一张纸。2019 年华为进实体清单。这两件事在中国科技行业留下的一样东西,叫肌肉记忆。一个被饿过的人修粮仓,理由很简单,不想再饿第二次。
这道配给防的是依赖。
坦率的讲,我如果坐在那个位置上,我也会这么批。一个国家的 AI 命脉整个押在别人家的工厂和许可证上,这个风险没人担得起。尤其当对方刚刚用同一套工具,收拾过你的两家同行。
但配给是有代价的,而且代价会立刻显形。
八卡 H200 服务器,去年年底两百万出头,今年十月末报到六百万,三倍。Blackwell 的机器更狠,两千万一台,因为它还在管制清单里,连配给的资格都没有。
六百万是中间人渠道报出来的价。官方许可进来的那批货,走的是另一套账,价格不在这个数上。
同一个型号,两个价。这就是价格双轨制。
八十年代中国管钢材、管彩电,计划内一个价,计划外一个价。双轨制一开,倒爷立刻长出来,因为差价本身就是一门生意,不用生产,只需要把货从低价那头搬到高价那头。倒爷这个词现在没人用了,活儿还是那个活儿。
今天的算力一模一样。只要有许可,就一定有没许可的货。只要有两个价,就一定有搬货的人。路透社说的「通过中间人和间接路线流入」,翻成人话就是这个。
双轨制是政策的产物。你要求定量供应,就得接受定量供应外面长出一圈黑市。这两件事一起出生,拆不开。
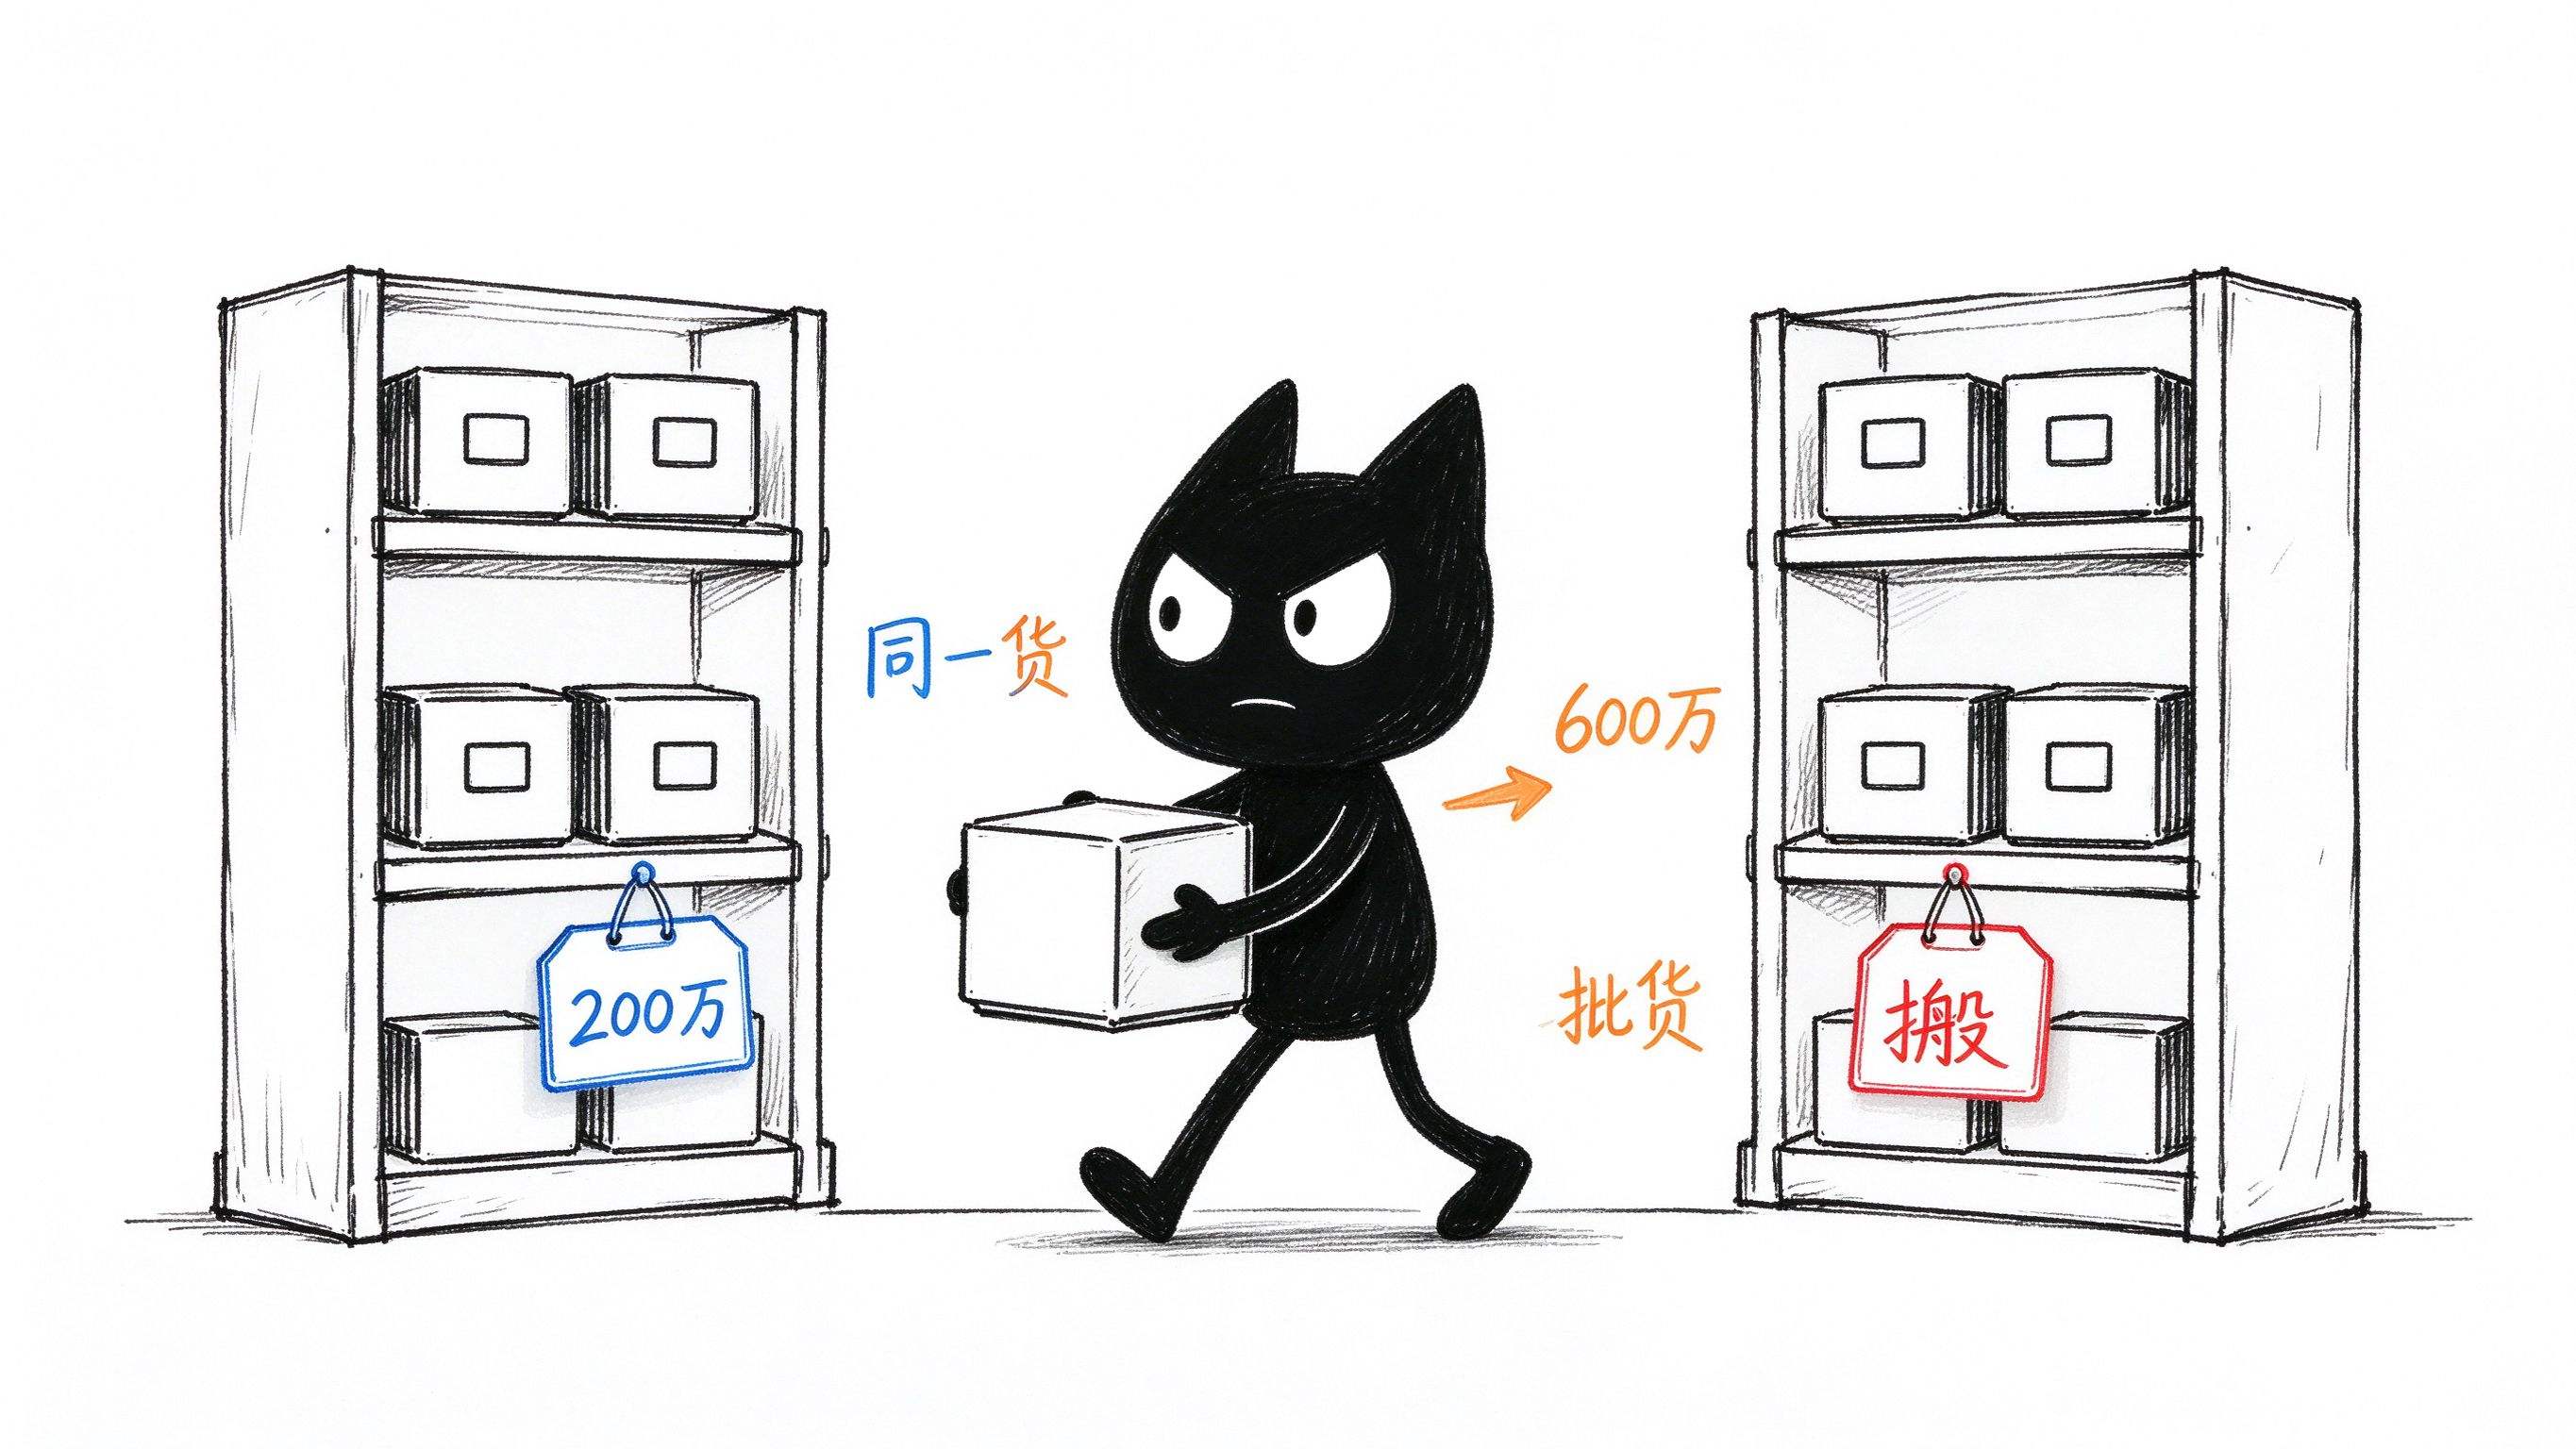
图三,同一个型号,两个价,中间就养出一门搬货的生意。
说到这儿,得把美国那边也摆上来。
环球时报六号那篇评论说得很直白。美国放宽 H200 对华出口,是在给已经下线、但落后最先进两代的产品找买家。而且美国有一部分人心里想的,是用这些不算先进的芯片把中国锁在现有的技术生态里,拖慢中国自研芯片的迭代,维持住那个技术差。
这个判断你可以不同意,但它至少解释了北京为什么这么谨慎。对方的善意里确实掺着算盘。
更有意思的是另一组数字。就在卡 H200 的同时,字节、阿里、腾讯三家订了超过三百万块 RTX Pro 5500,一款为了合规专门降过规格的卡,标价合计超过三百五十亿美元。这是真金白银,一分没少花。
北京一直在买美国货,它只是不按美国给的那份清单买。
能替代的,用国产。替代不了的,用降规的凑。最要命的那一环,少量买最好的。三层结构,粗细粮搭配。这套安排放回粮票年代,一点都不违和。
粮票这个东西现在的年轻人可能没感觉了。它的逻辑很朴素,定量、凭票、够吃但不够囤,目的是让有限的粮食撑到下一季收成。
算力配给是同一个逻辑。够训练,不够依赖,撑到国产产能跟上来。
这话不是我替谁说的。环球时报那篇评论的结尾就写着,中国算力产业这几年的发展已经证明,走一条独立的技术路线也能撑住产业增长。你可以说这是官方媒体的口径,但它至少代表了决策层愿意公开表达的判断。
环球时报那篇评论里还有一句反问,我觉得挺准。美国有些人,中国买英伟达芯片的时候慌,中国不买的时候也慌。
那批货已经下线了,这才是慌的根子。货压在仓库里,就是压在财报上的存货和收入。这东西不会因为北京卡了一道关就消失,它只会从英伟达的报表,挪到某个经销商的报表。
回到那个更大的问题。
芯片现在已经是战略物资了。
1973 年石油禁运之后,全世界都学会了一件事。战略物资不能全靠市场定价,得有储备,得有配给,得有不计成本的备用方案。那次之后各国建石油储备,建的时候没人算得过账,禁运一来全算过来了。
现在算力走到了同一个位置。它决定一个国家能不能训模型、能不能跑推理、能不能在下一个十年有自己的 AI 产业。这种东西的价格,本来就不该由市场单独决定。
所以你在国内买不到便宜的 H200,这恰恰说明政策生效了。
这话听着刺耳,但它成立。一个国家为了保护自己的产业能力,主动让本国企业买贵一点的算力,经济学上叫机会成本,政策语言里叫战略忍耐。
路透社稿子最后有个细节。工业和信息化部、国家发展改革委都没有回应置评请求,英伟达、阿里、字节、DeepSeek、腾讯也都没有。
没有人认,也没有人否认。六十万块芯片就那么躺在仓库里,等一张纸。
三年前,这张纸在华盛顿。你得等美国商务部点头。
现在这张纸在北京。你得等一张进口许可证。
同一批货,同一条缝,关卡从太平洋对岸搬到了自家门口。
一张纸的分量,比四千亿的货还重。这三年里唯一没变的东西,是那批芯片还在等。
谢谢你看我的文章,我们,下次再见。
/ 作者:青玉白露
评论区
欢迎留下你的看法,支持匿名评论。
你的评论会公开展示,建议填写便于交流的昵称,并尽量提供有信息量的反馈。