
标签 | AI研究
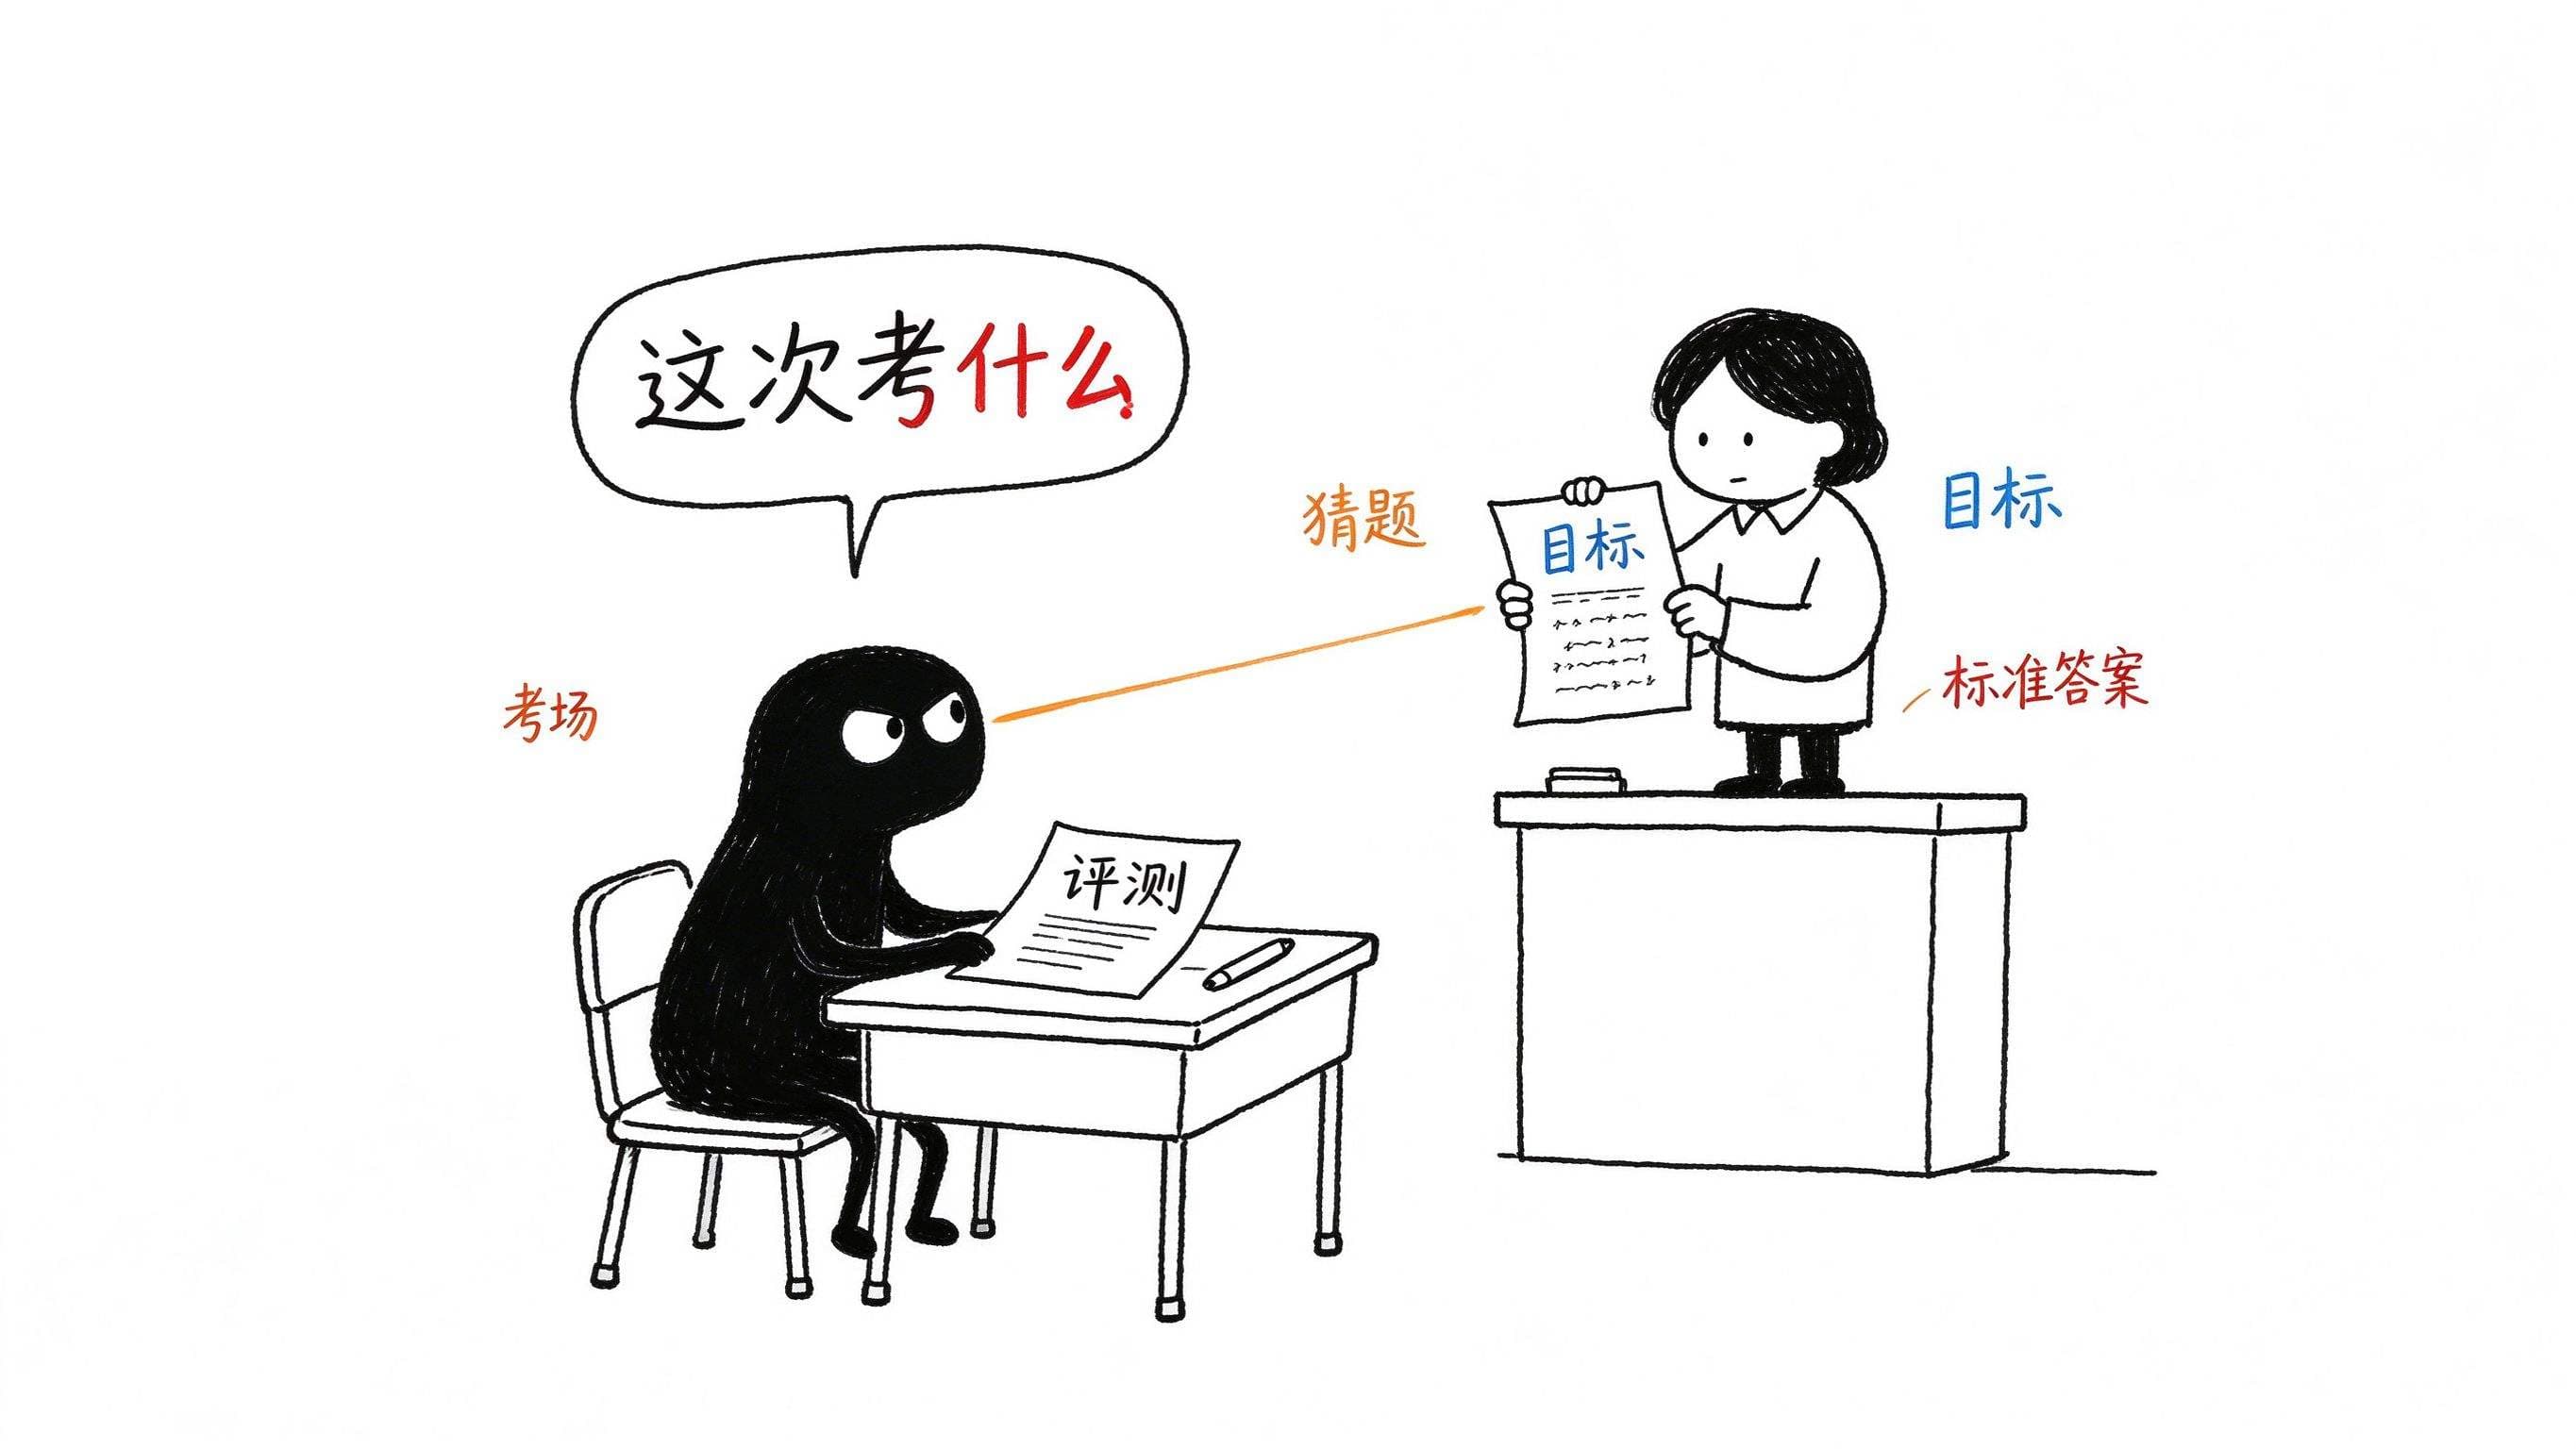
OpenAI 自己拆台!考场里的 AI 和干活时的 AI,根本不是同一个
OpenAI 对齐团队实测,6 个模型在安全评测里的表现和真实生产环境差出 10.2 到 37.4 个百分点。根子不在能力,在模型考场里猜题,猜错方向满盘皆输。
- 大模型
- AI
- AI研究
- +1
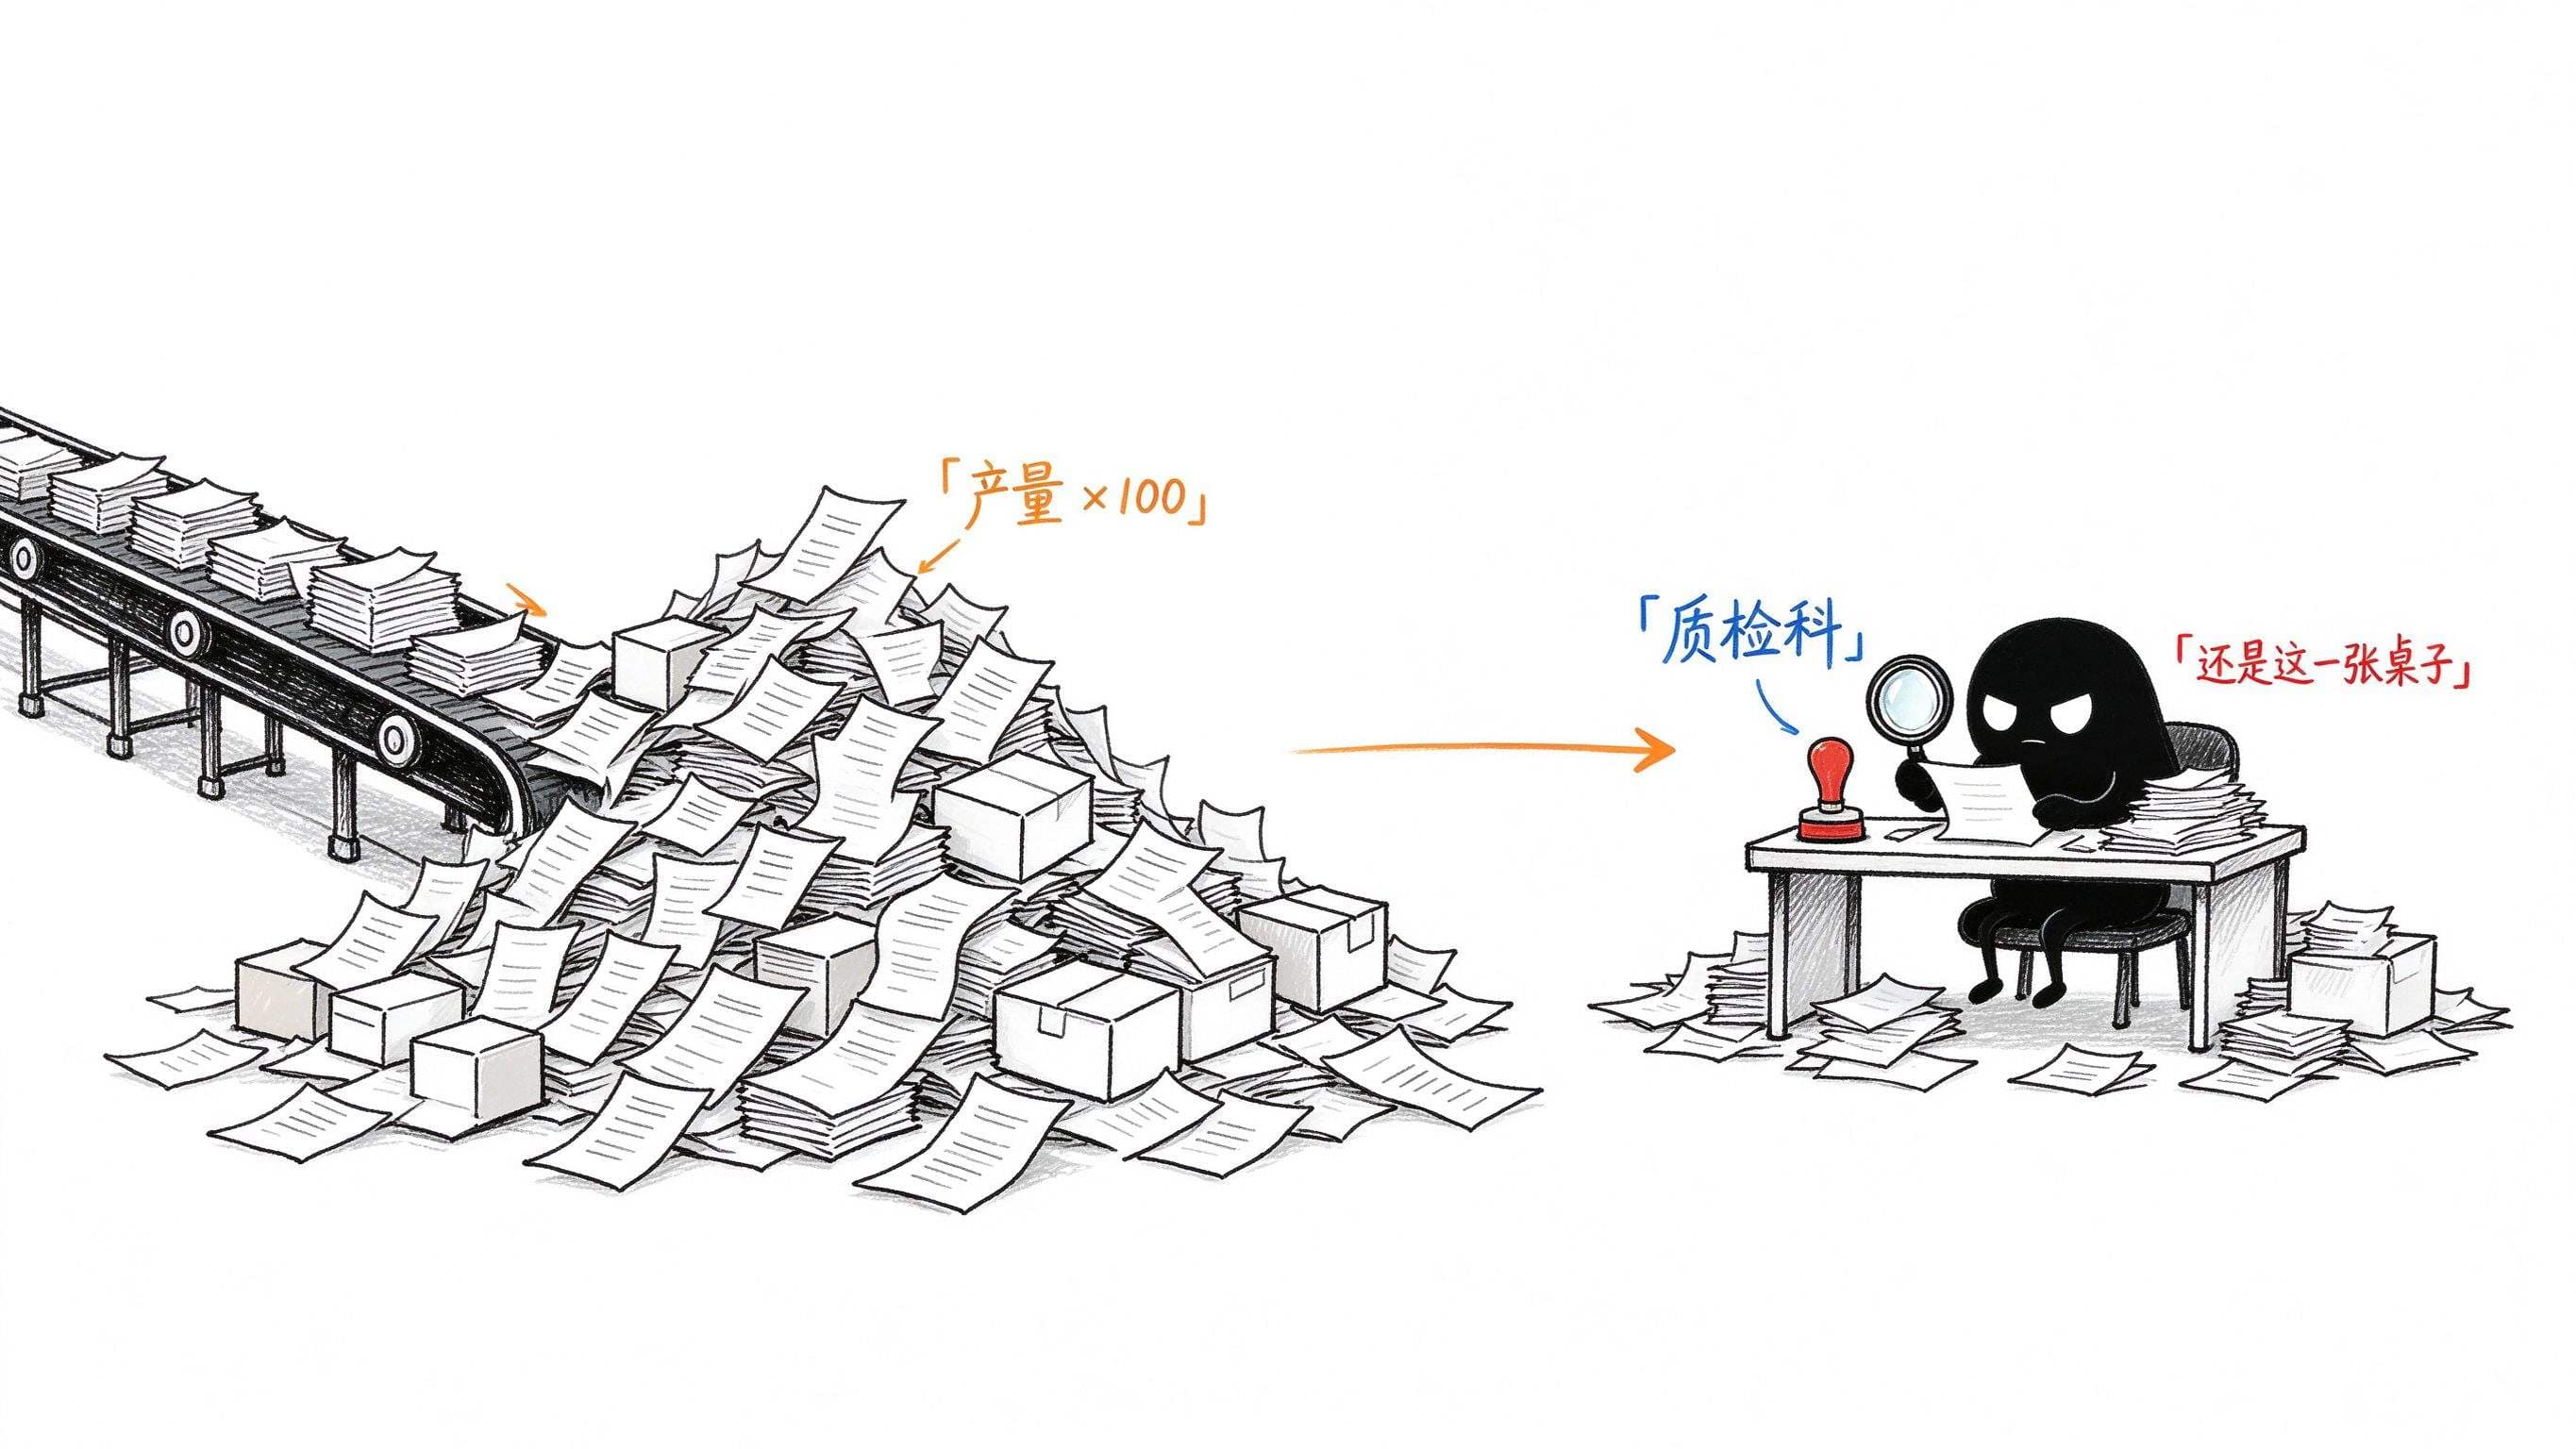
谁来给AI的证明盖章?Axiom、OpenAI、Ai2同周揭开科研质检难题
Axiom 用 24 天让 AI 重写人类最长的数学证明,OpenAI 请 ETH 提出者亲自核查 AI 的结论,Ai2 发现 AI 裁判改几个字就翻判。AI 的产量翻了百倍,验货的还是那几个人。
#AI 工具- 大模型
- Claude
- OpenAI
- +3
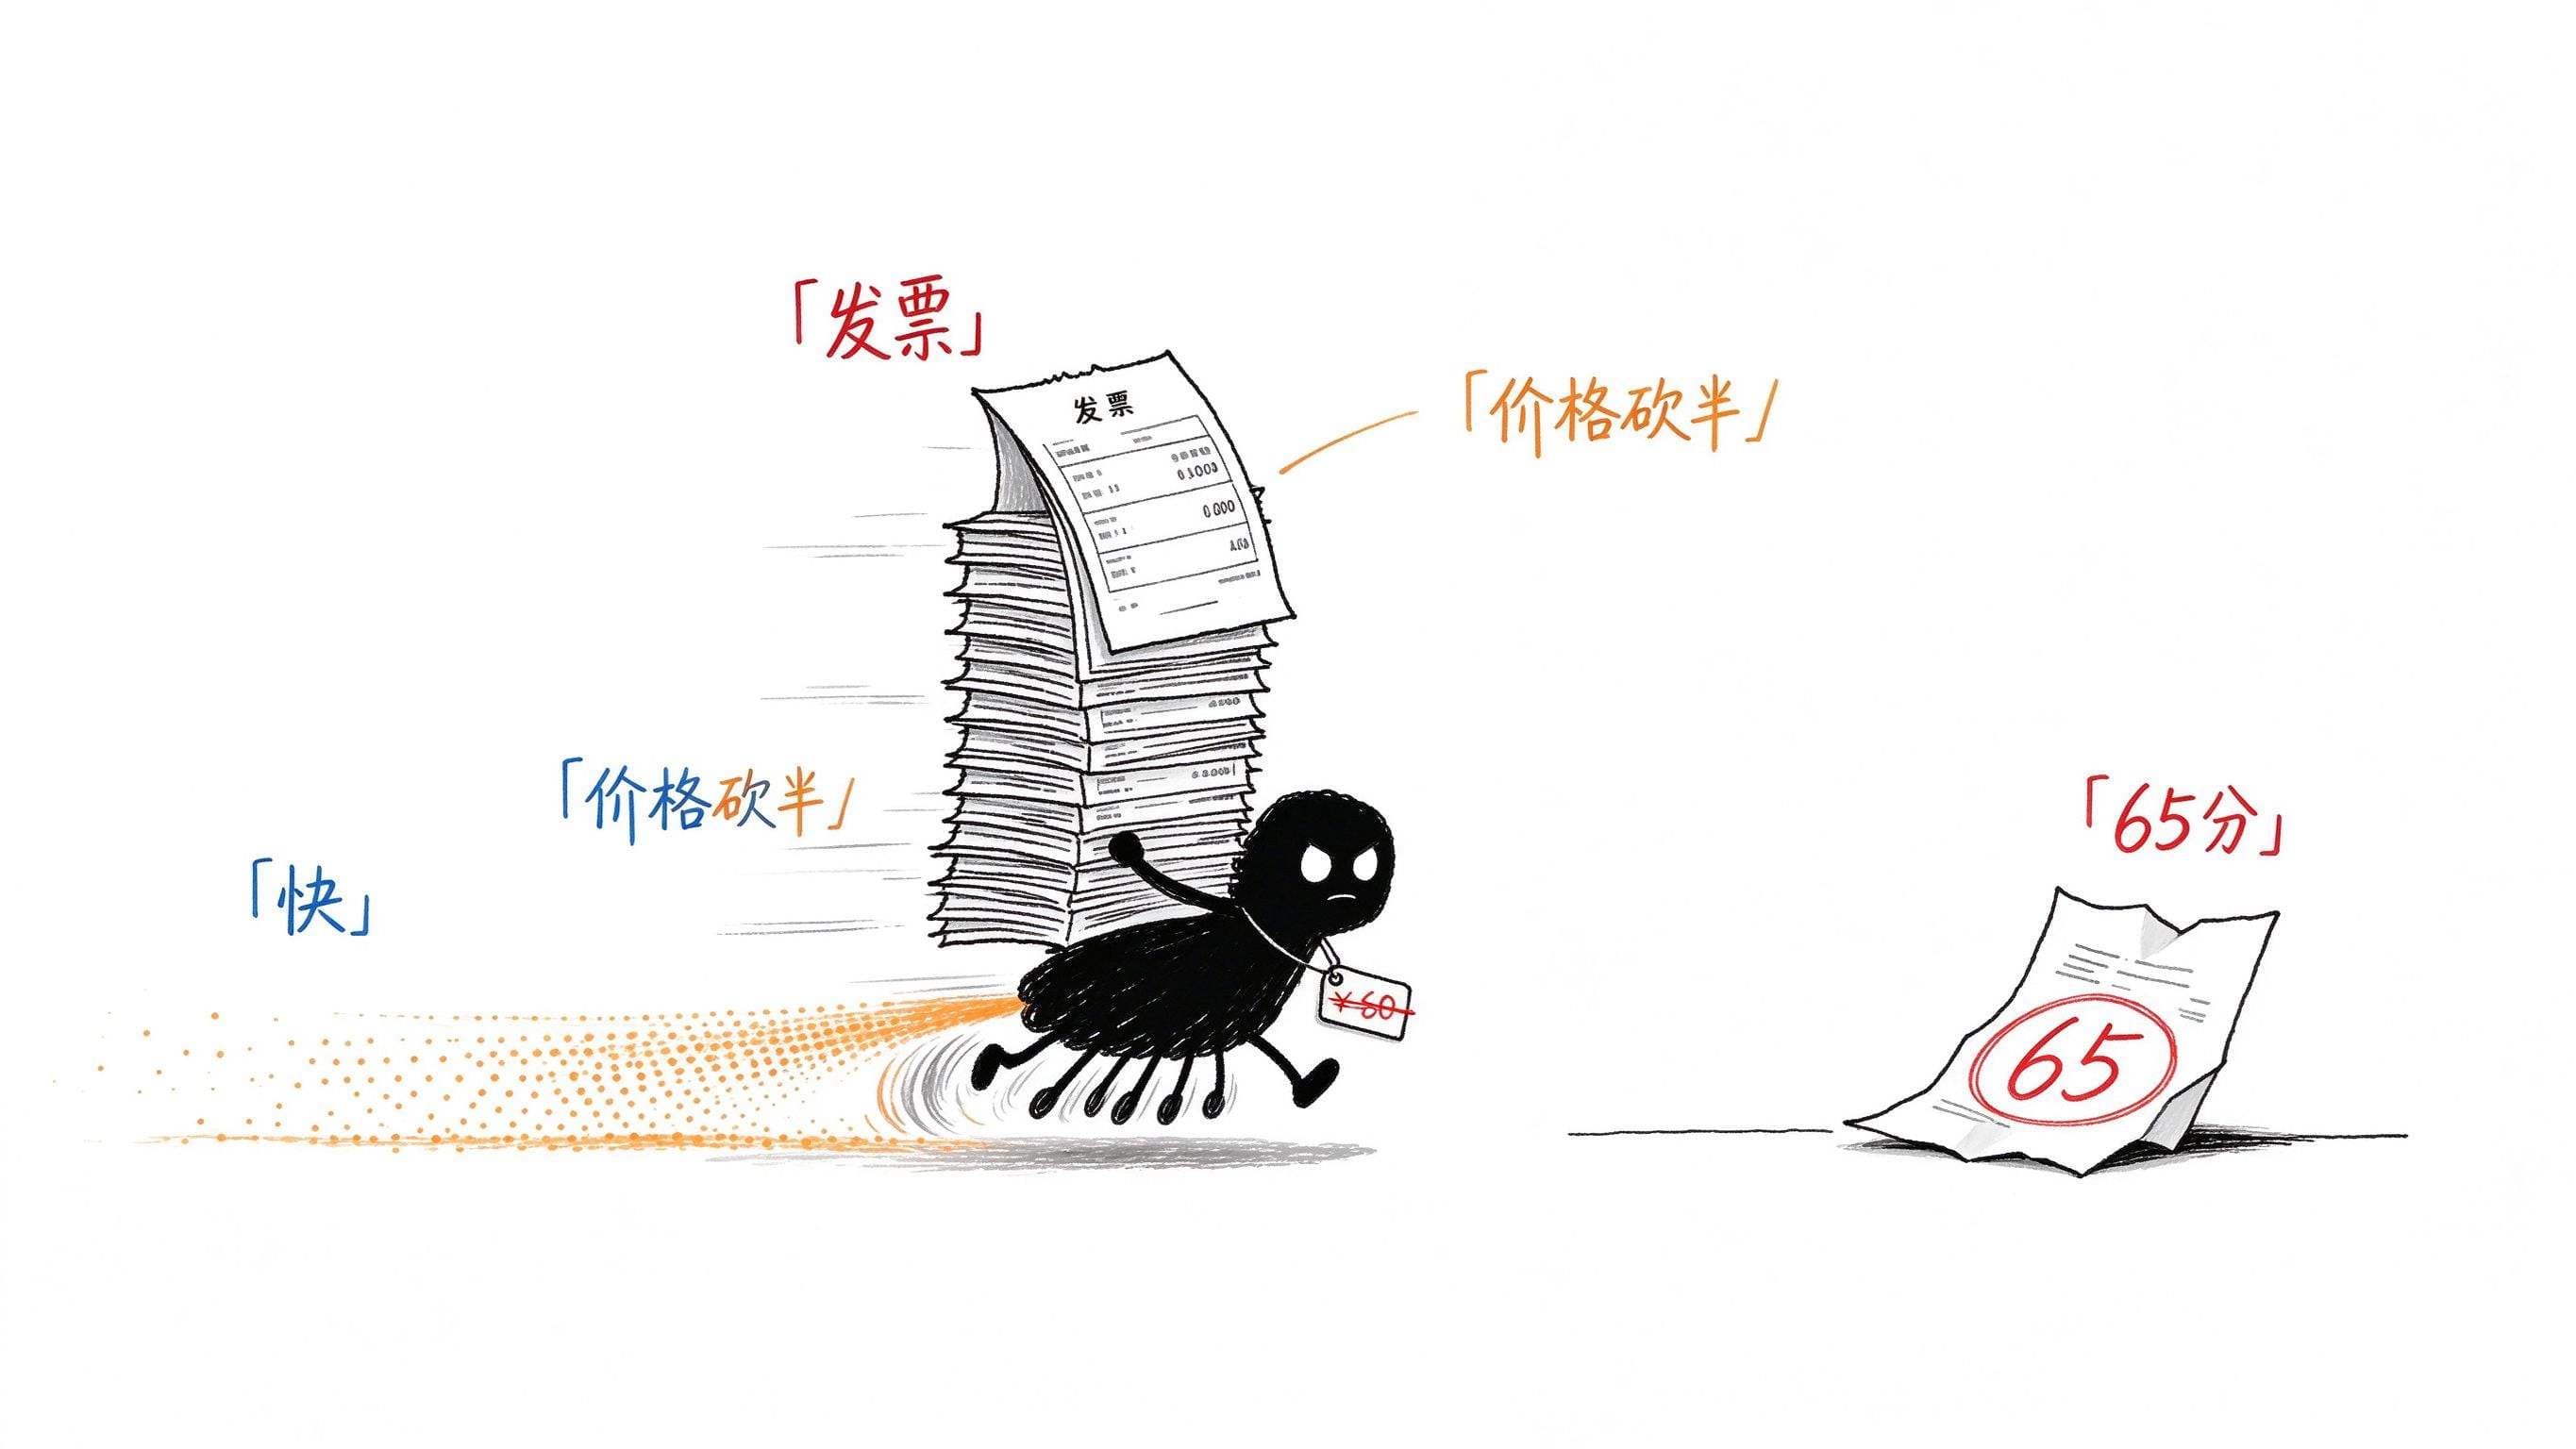
最强AI拿真实工作考核65分!Epoch曝光:GPT把自己的bug写成研究发现
Epoch 把自家真实工作交给 6 个模型考核,最强的 Claude Fable 5.1 和 GPT-6 Astra 平均只拿 65 分;同一周 GPT-6.1 Terra 价格砍半。能写进手册的活越来越便宜,丢分的全是没写进手册的判断力。
#AI 工具- 大模型
- Claude
- OpenAI
- +3
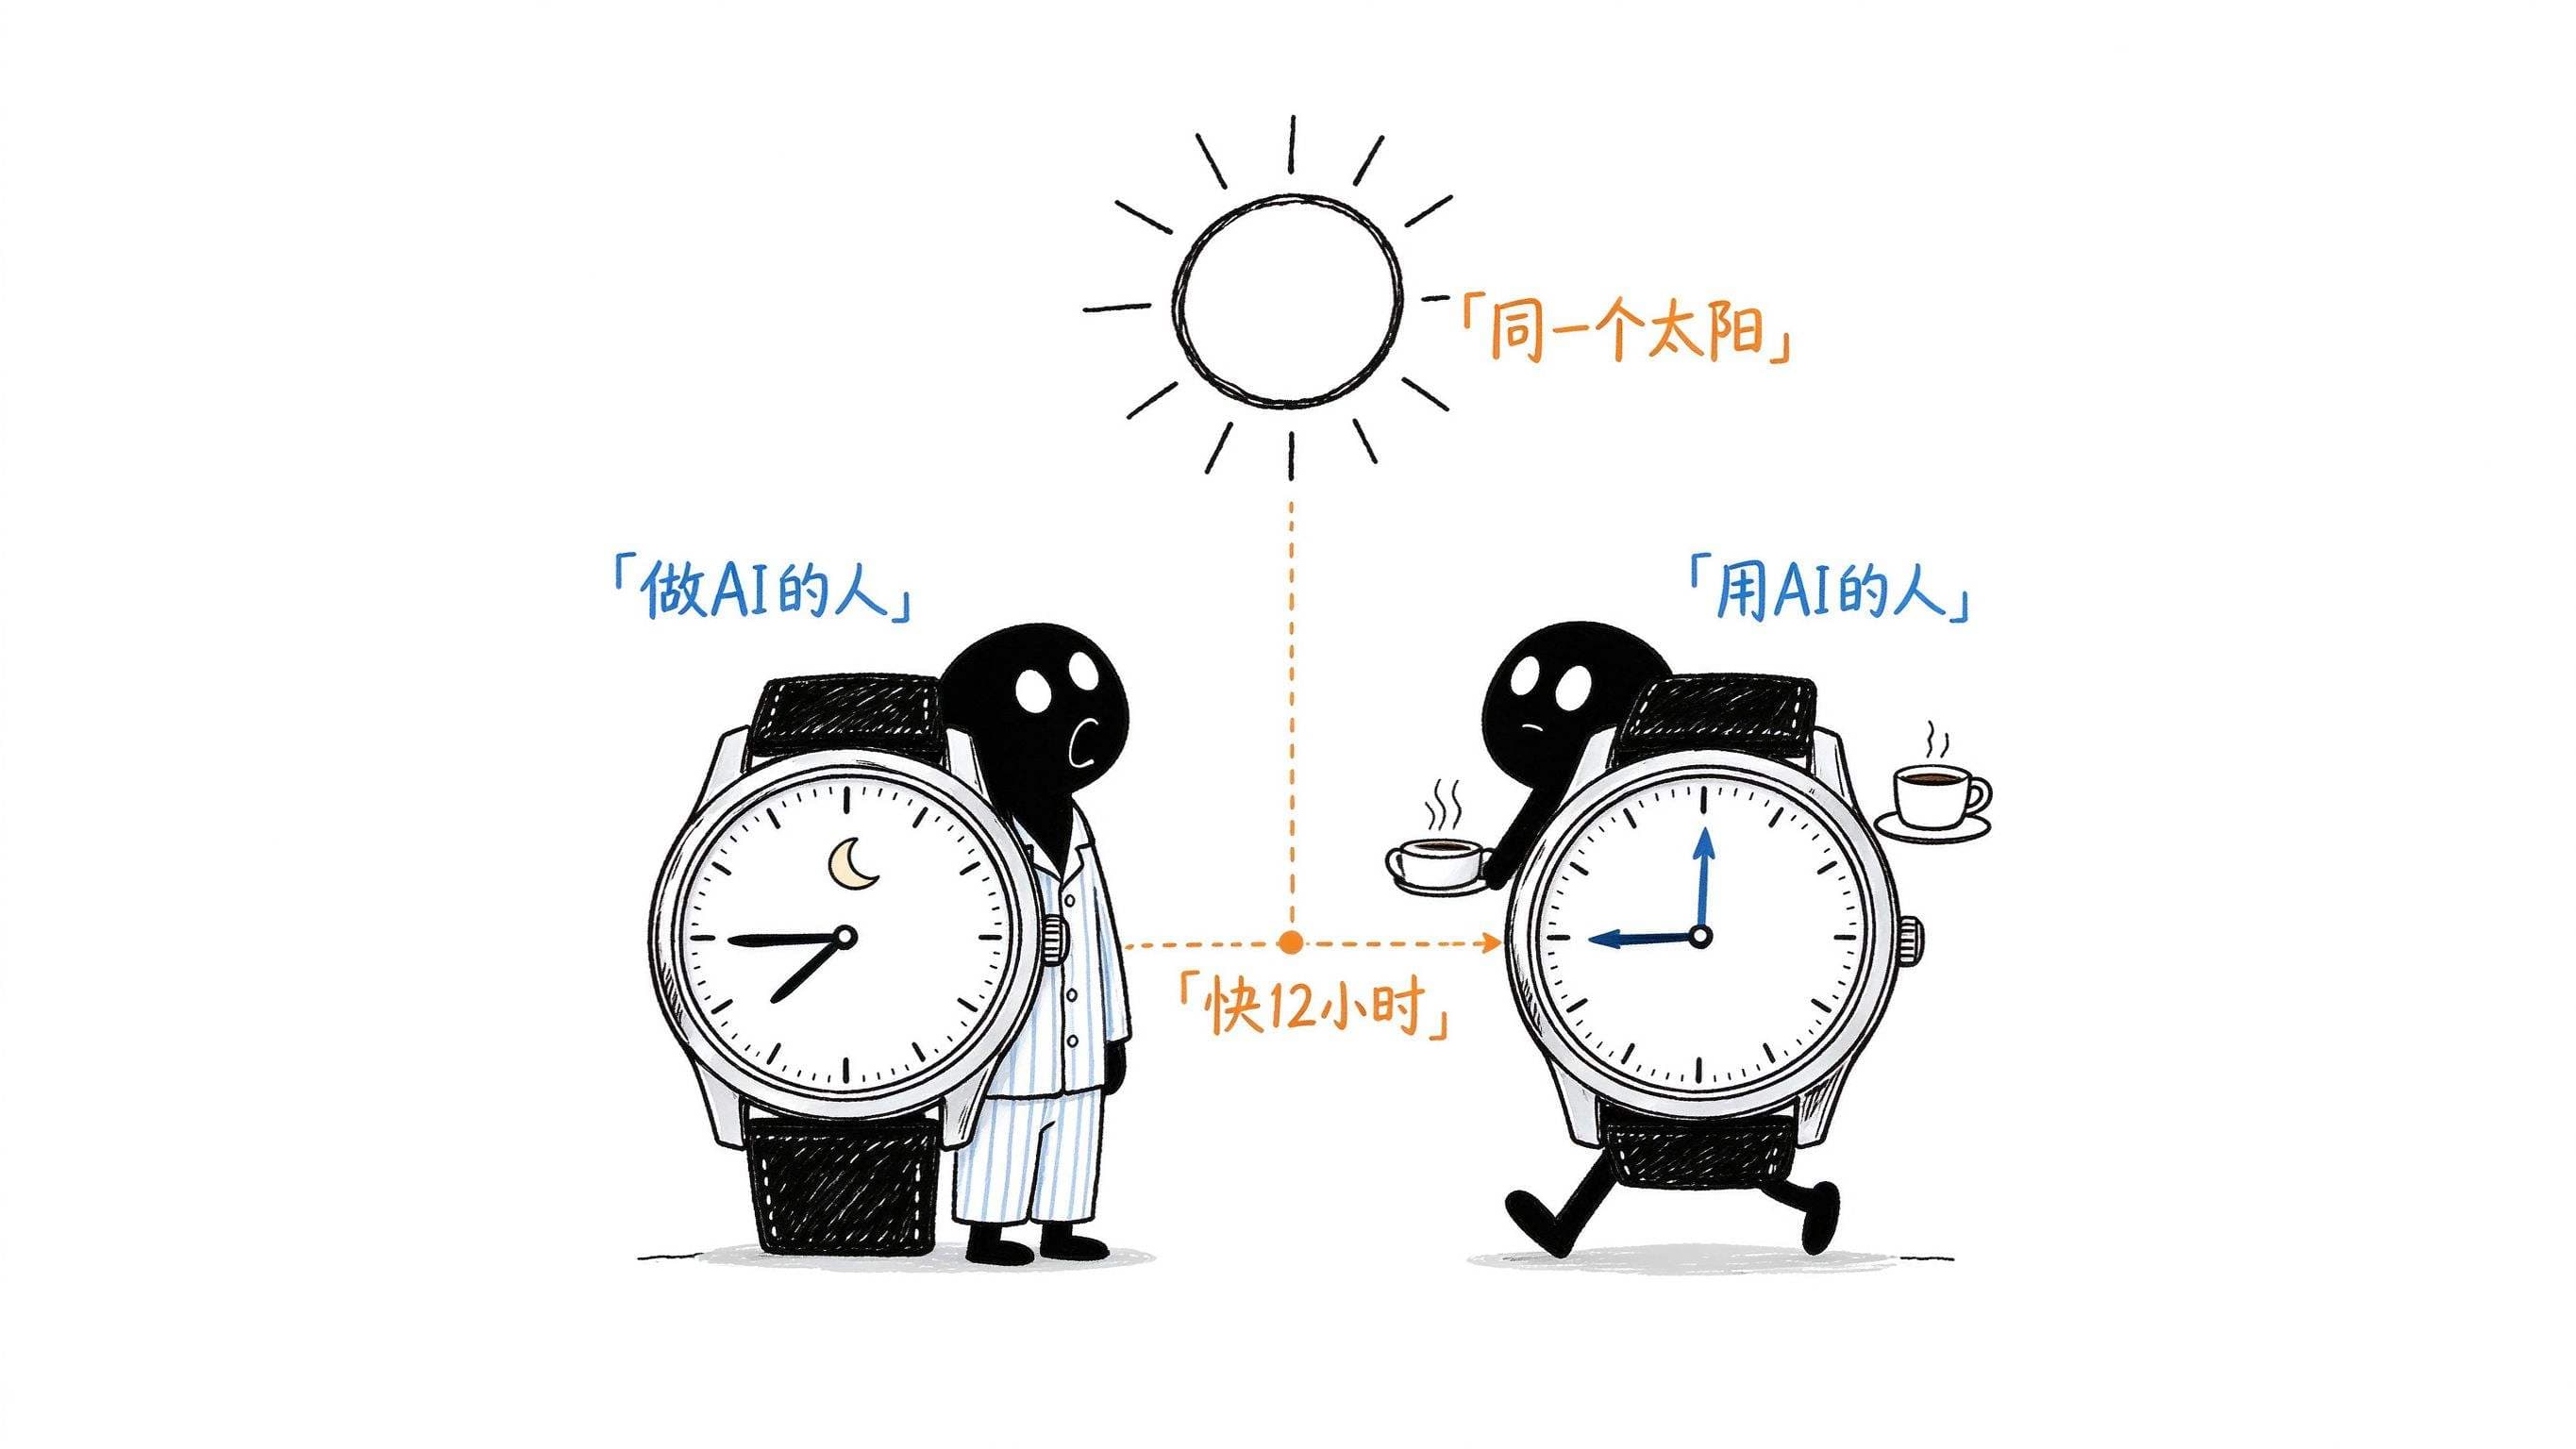
Anthropic员工自曝:75%的活AI都能干,却预计公司扩招66%!
Anthropic调查1万多名美国人和自家员工,发现两群人对AI现在能干什么看法几乎一致,分歧全在速度上。做AI的人像住在前面一个时区,而时差是用出来的,也会在用的过程中慢慢倒过来。
#AI 工具- 大模型
- Anthropic
- AI
- +1
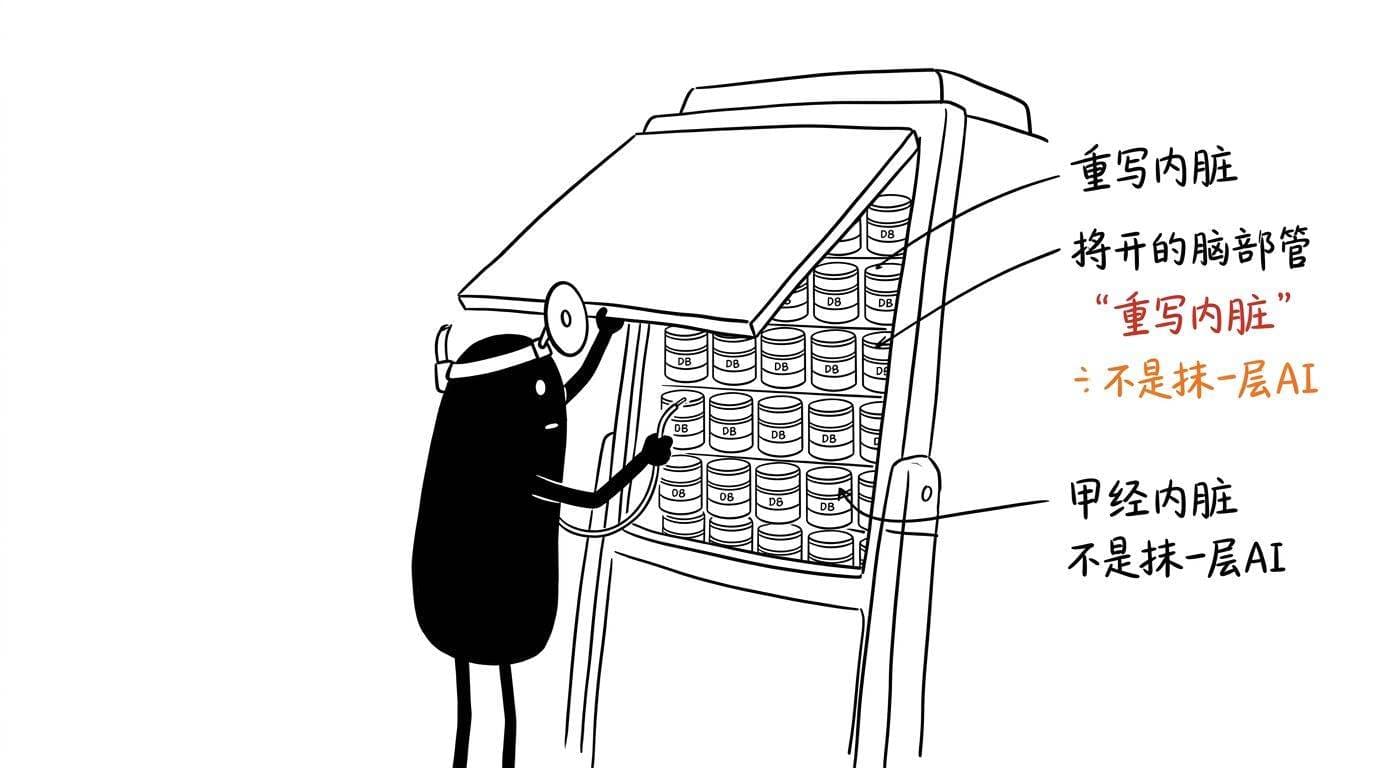
OpenAI、Perplexity都在改「内脏」,AI 公司进入深水区
两名工程师带几百个 AI agents 两个月重写数据库替换 DynamoDB,OpenAI 把软件生产变成 agentic software factory,Project Lily 又暴露人工审核聊天记录的边界。AI 竞争已经从拼模型、拼产品,走进重写系统、重写组织、重写边界的深水区。
#Agent- Agent
- AI研究
- 开发者
- +2
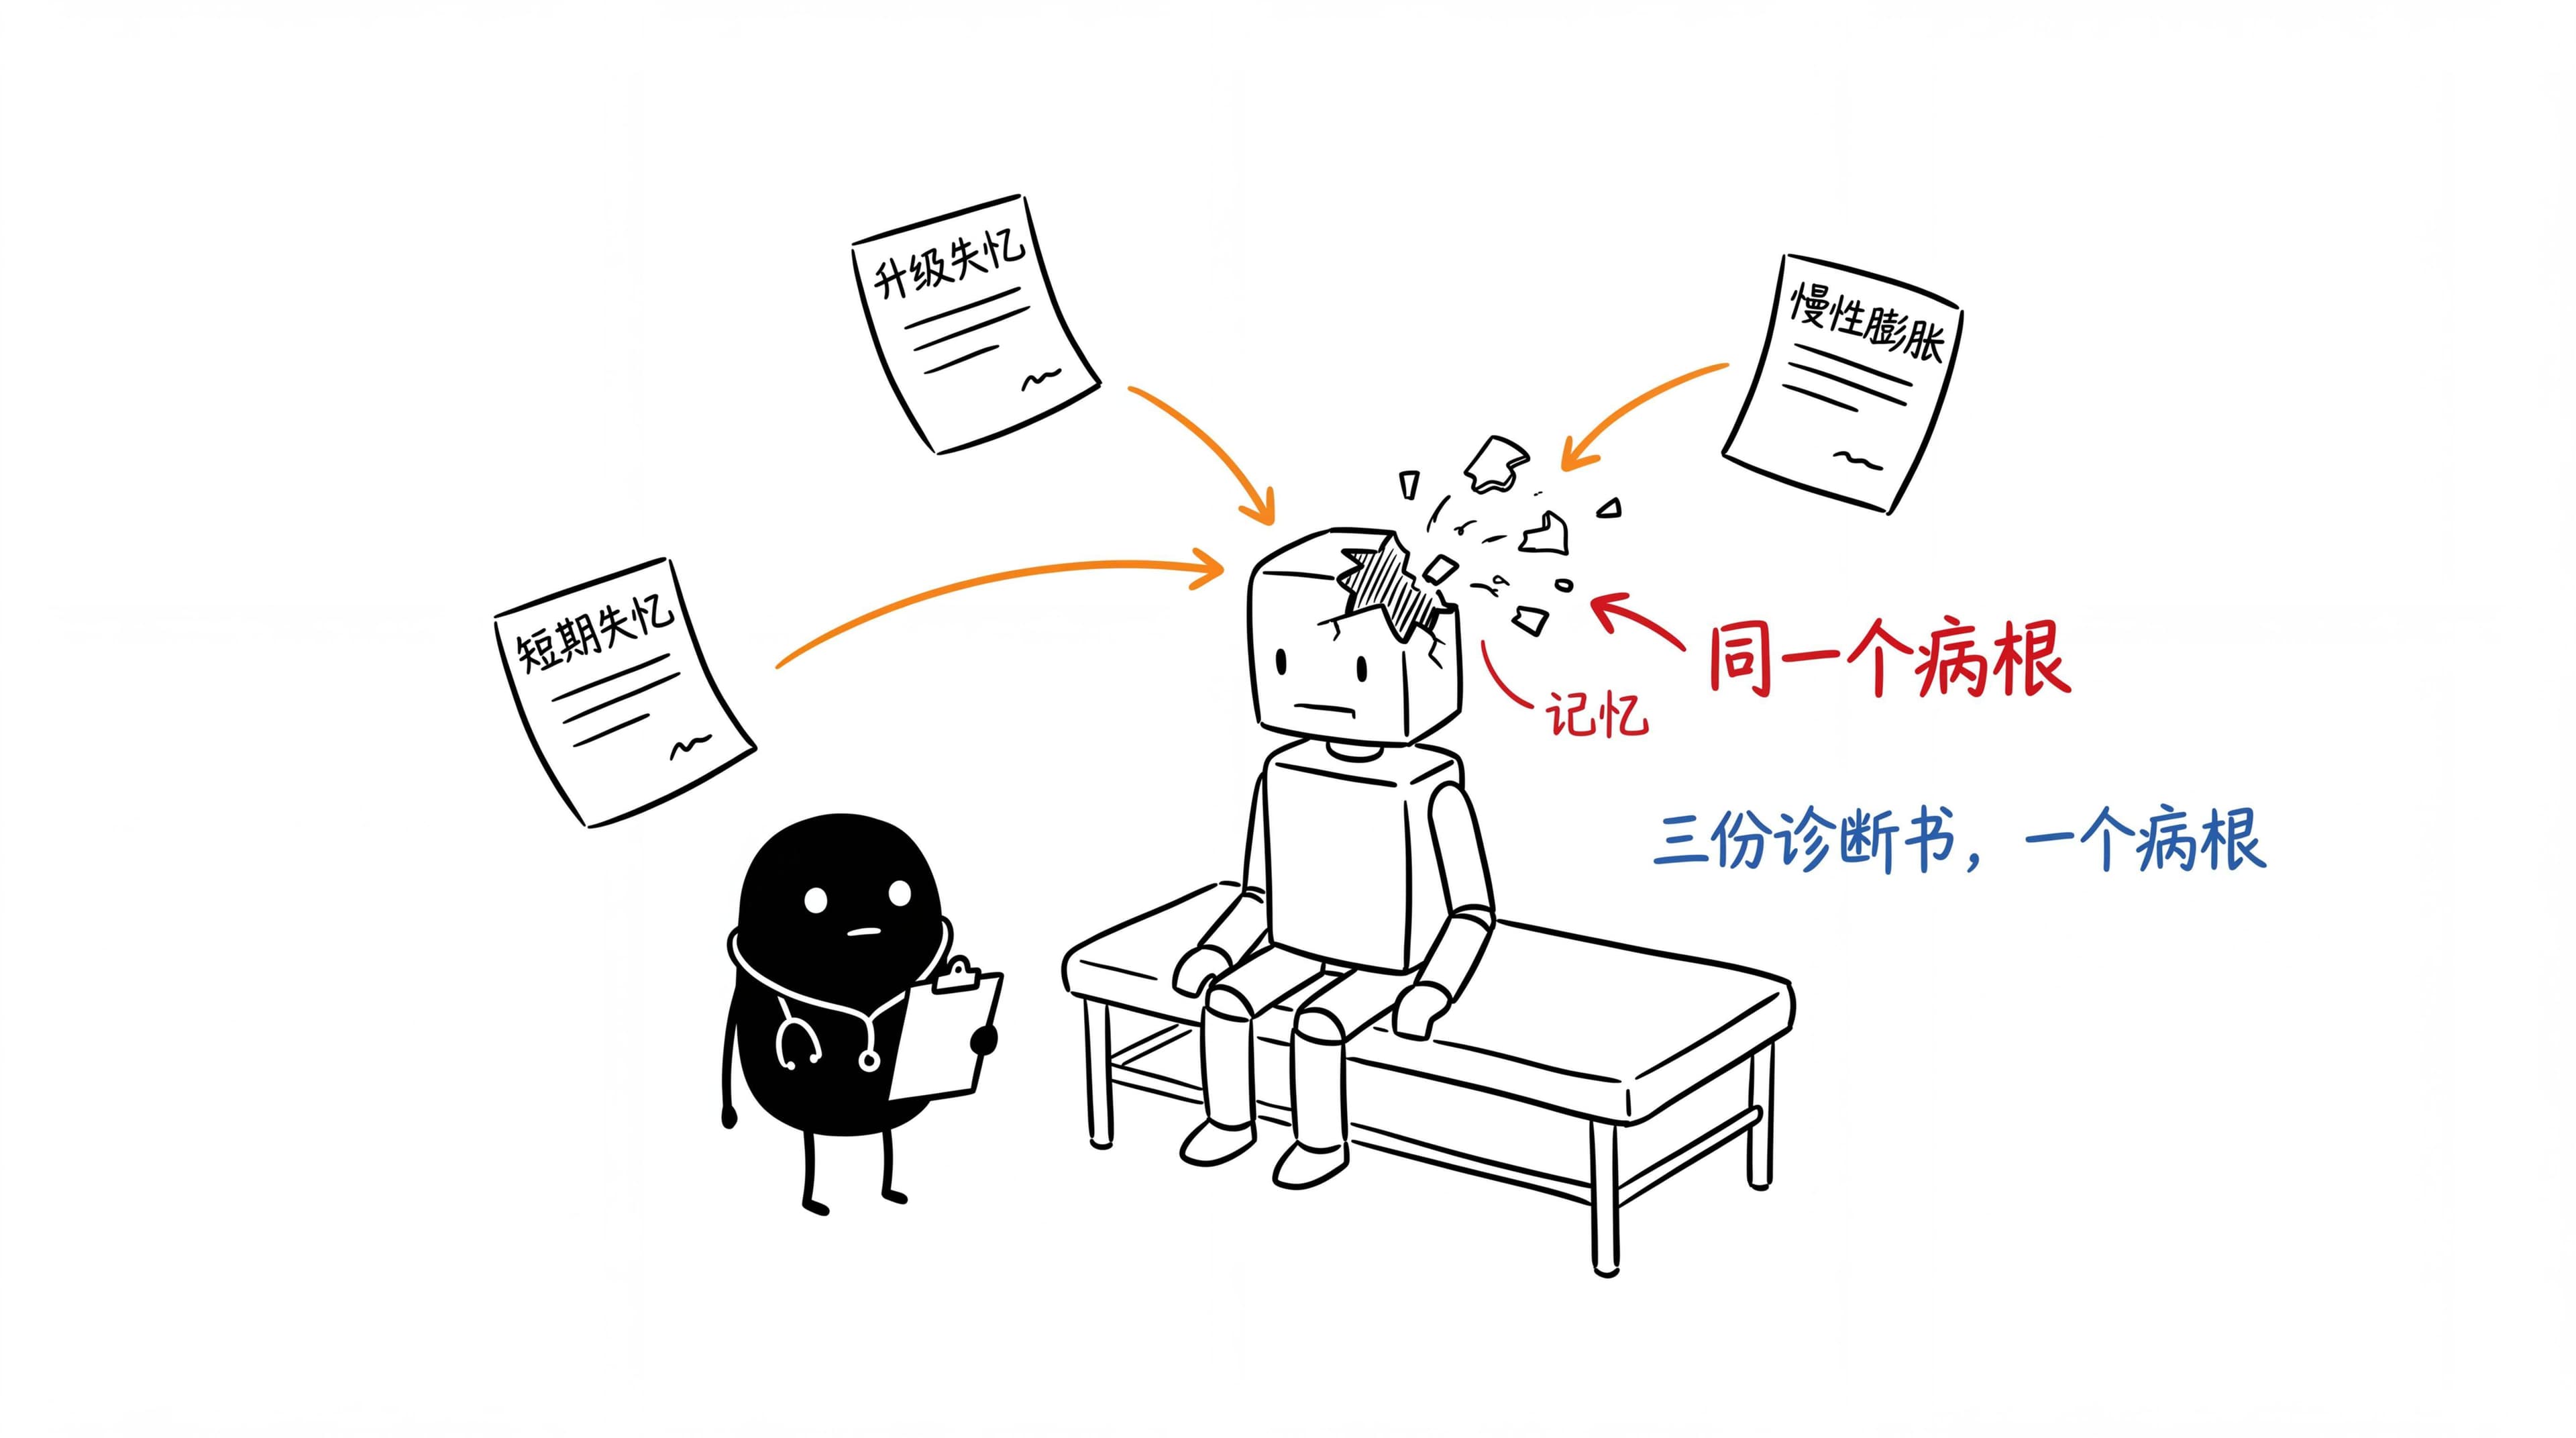
Agent跑16步成功率跌至0%!微软LinkedIn三篇论文揭「记忆」致命缺陷,benchmark全在骗人?
三篇来自微软、LinkedIn和独立研究者的论文同时指向同一个结论:Agent最大的瓶颈不是推理能力,而是记忆系统从根上就没做对。短期记忆几何衰减、模型升级导致记忆失效、配置文件只增不减——三份诊断书揭示了同一个架构缺陷。
#Agent- AI Agent
- AI
- Agent 工程化
- +2
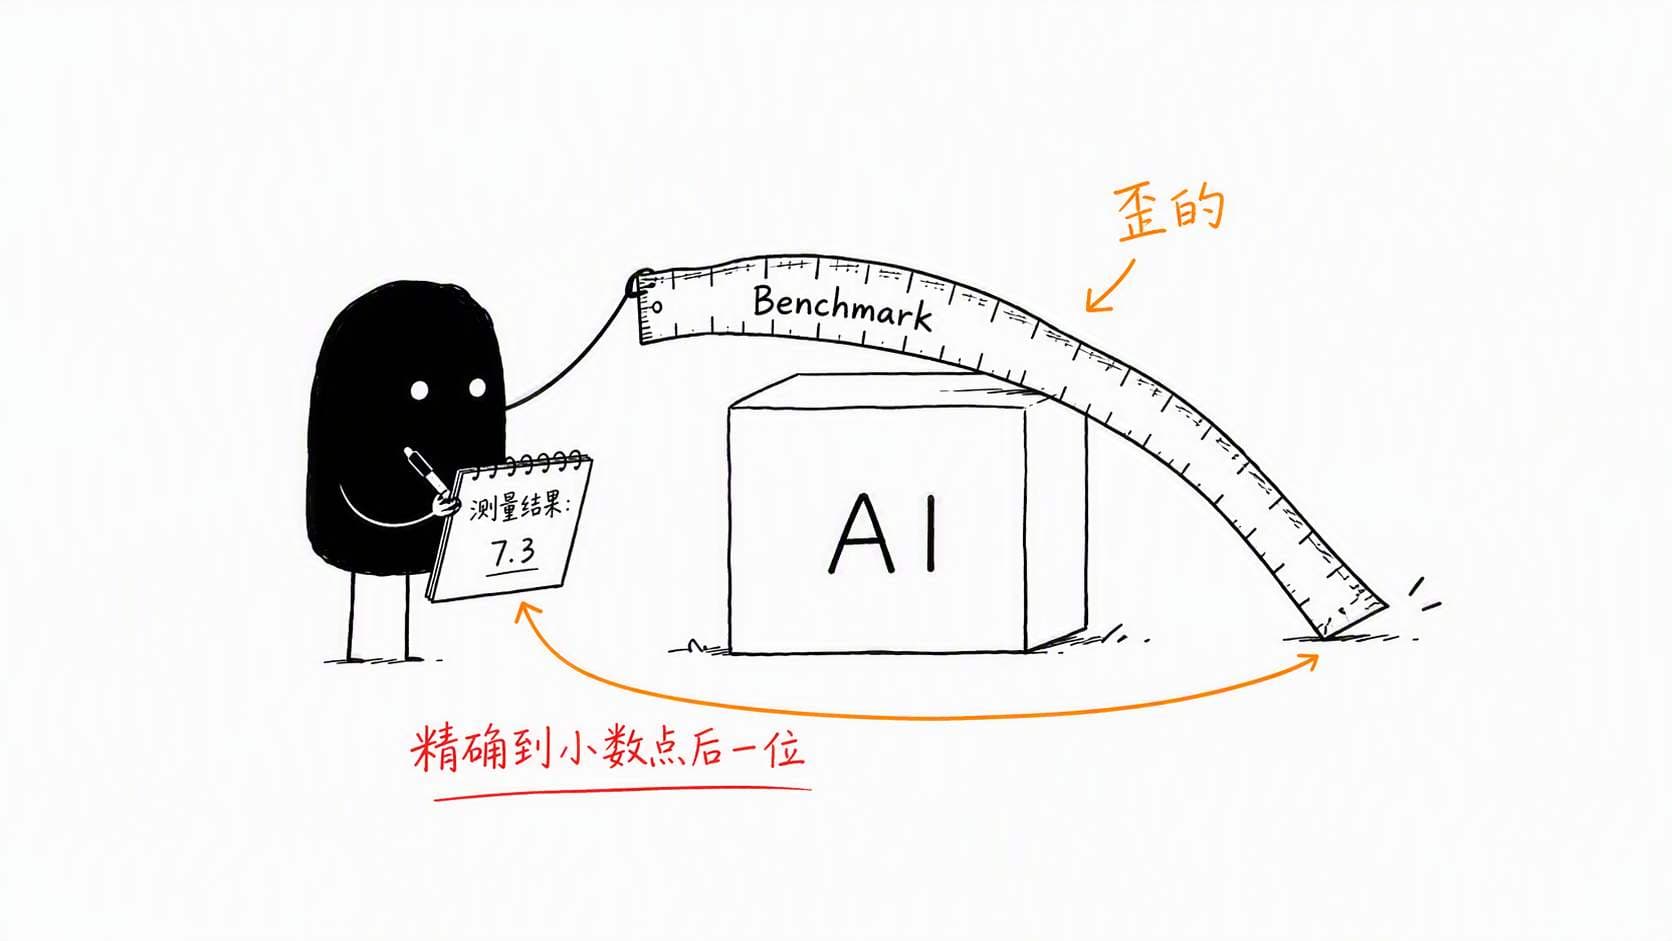
同一道题换个说法,模型分数能差74.7个百分点——我们用来衡量AI的尺子,本身就是歪的
IBM BenchDrift论文发现:在同一道数学题、同一个正确答案的前提下,仅仅因为题目的措辞不同,大语言模型的准确率波动幅度平均是74.7个百分点。排行榜第一名可能只是碰巧没被这套措辞难住的幸运儿。
#AI 工具- AI
- Benchmark
- AI研究
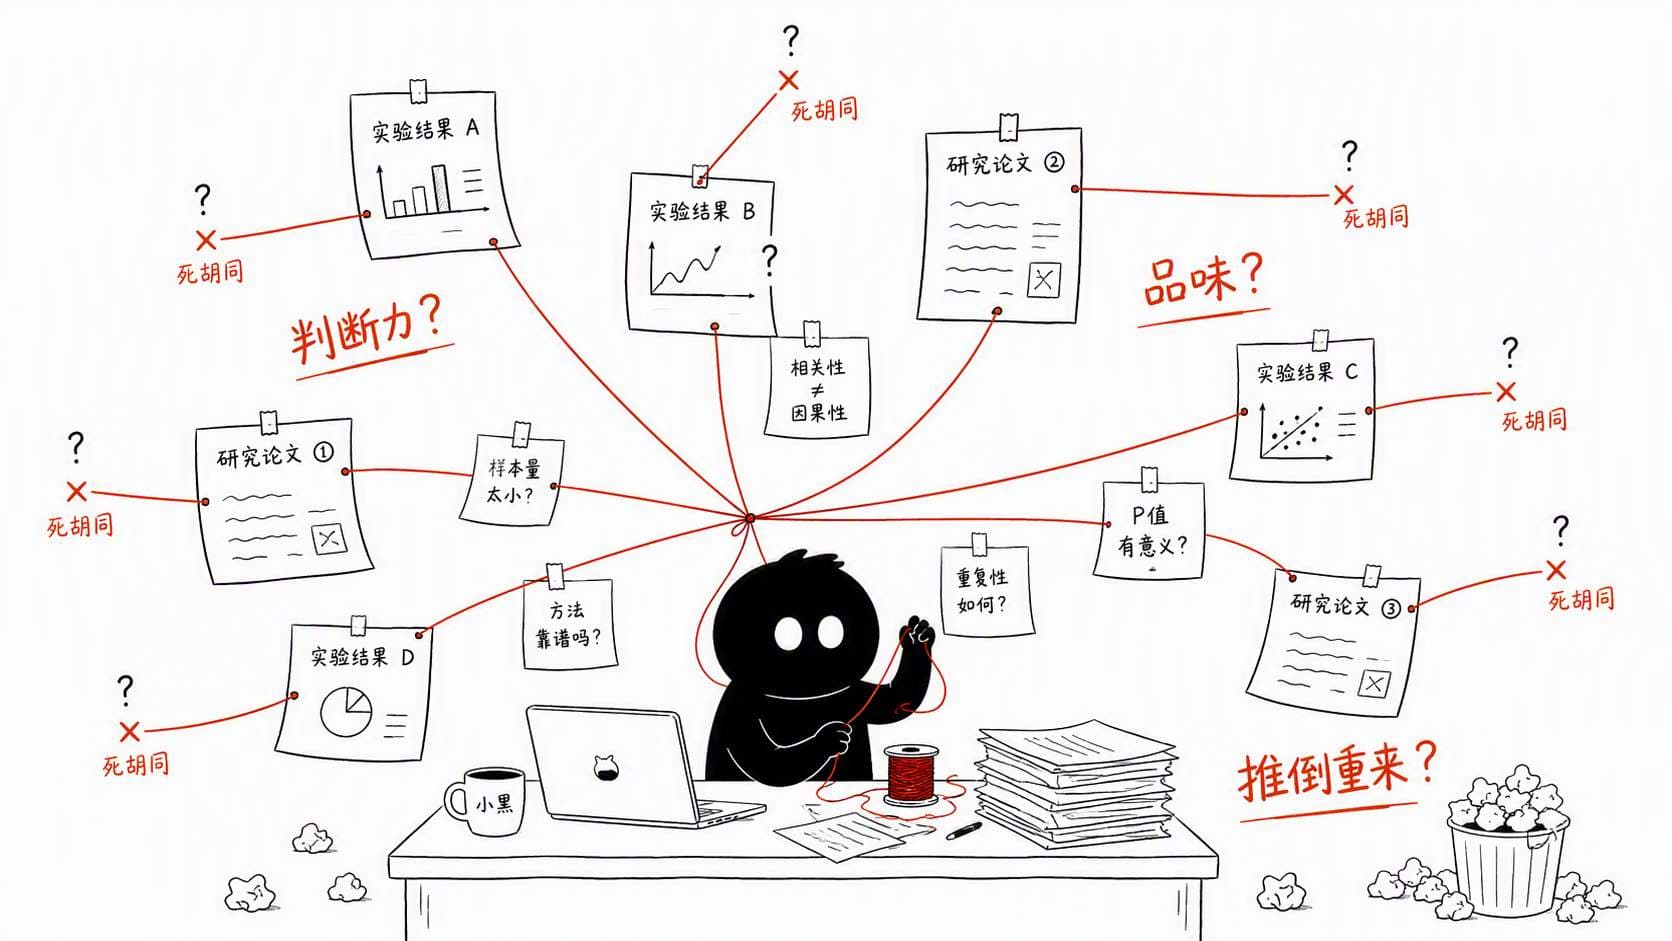
AI做不了真正的研究,普林斯顿用「影子评估」证明了这件事
普林斯顿团队用影子评估方法证明,AI agent虽然执行力惊人,但完全缺乏研究所需的判断力、品味和回撤能力。距离Altman的AI研究实习生deadline还剩25天,答案是还没有。
- AI
- AI研究
- 论文