
37999 元的一台笔记本,开售几分钟就被抢空了。
按卡兹克在北京首发现场的记录,10 月 16 日晚上 8 点,搭载英伟达 RTX Spark 的华硕 ProArt 创 16 开售,128GB 统一内存加 1TB 硬盘。他去京东看了一眼,几分钟不到,就没货了。
三万八,已经不是随手买个新玩具的价格了。ChatGPT、Claude、DeepSeek 都能直接用,为什么还要花这笔钱,把一个能力未必更强的模型装回家?
我更在意的是另一笔账。偶尔问几句话,和让 Agent 在后台一天跑几千次,花的根本不是同一种钱。对后一种用法,本地 AI 的吸引力,就藏在每一次调用都要掏钱的账单里。
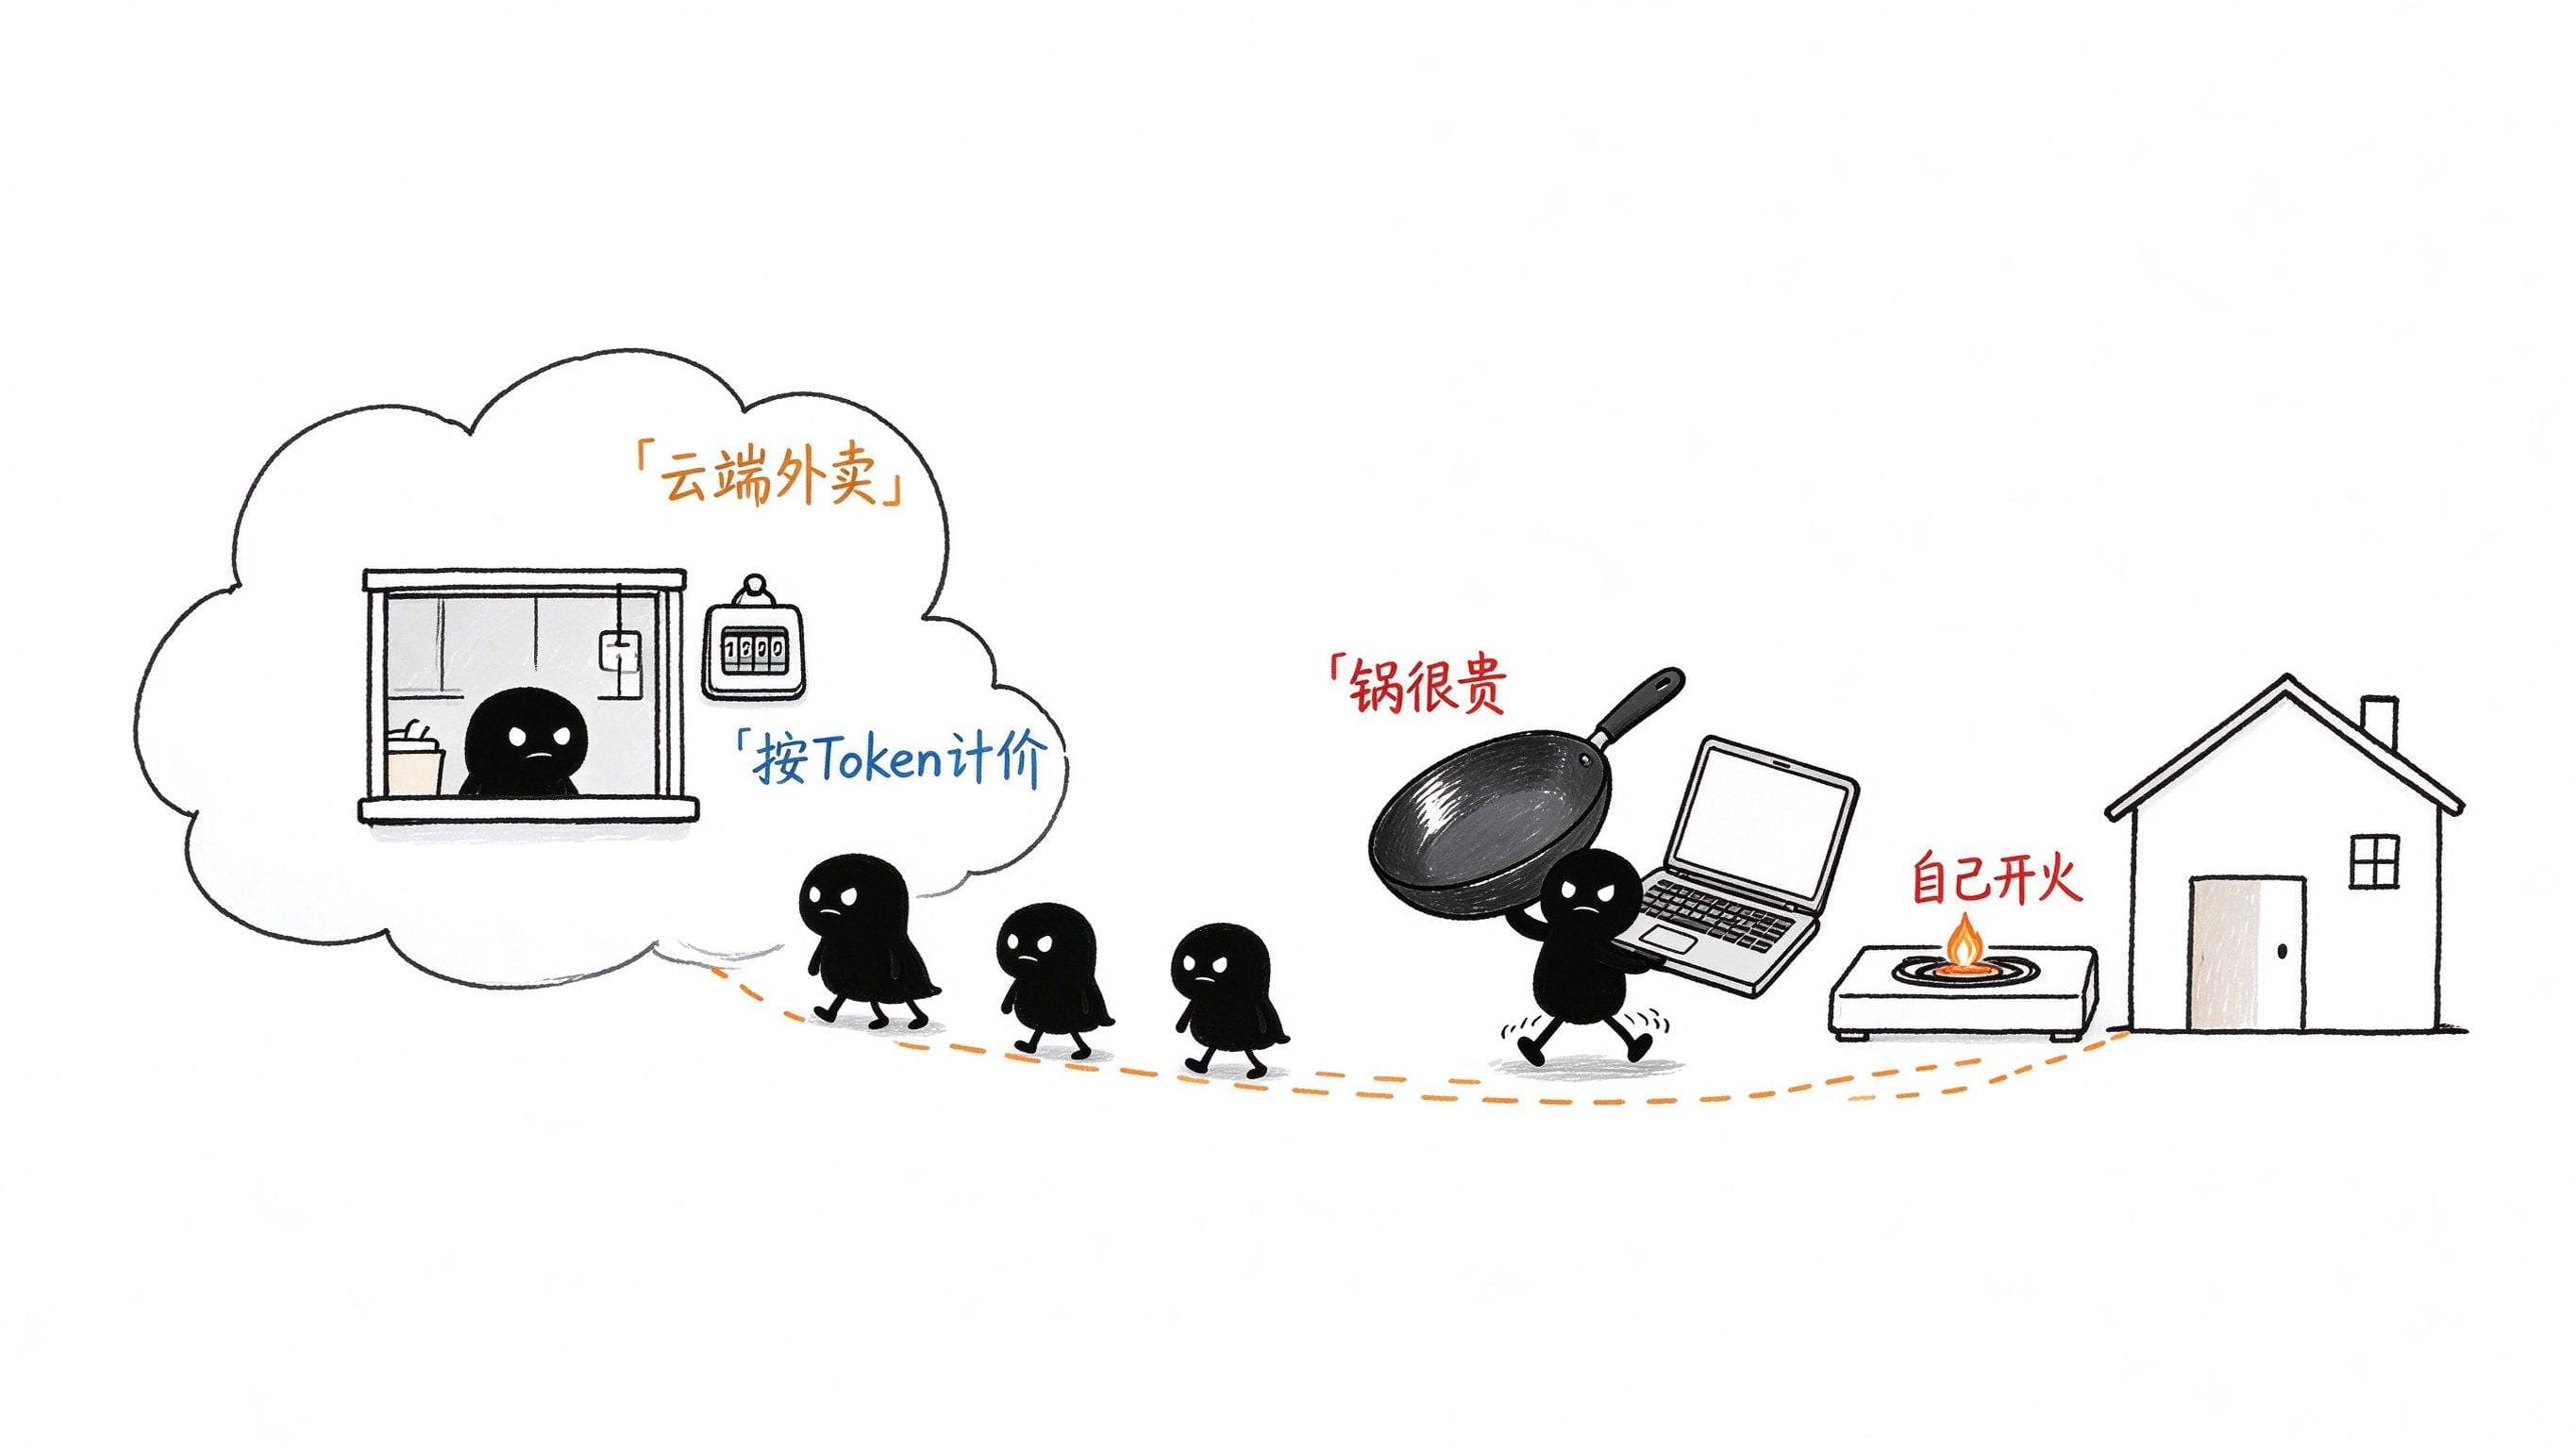
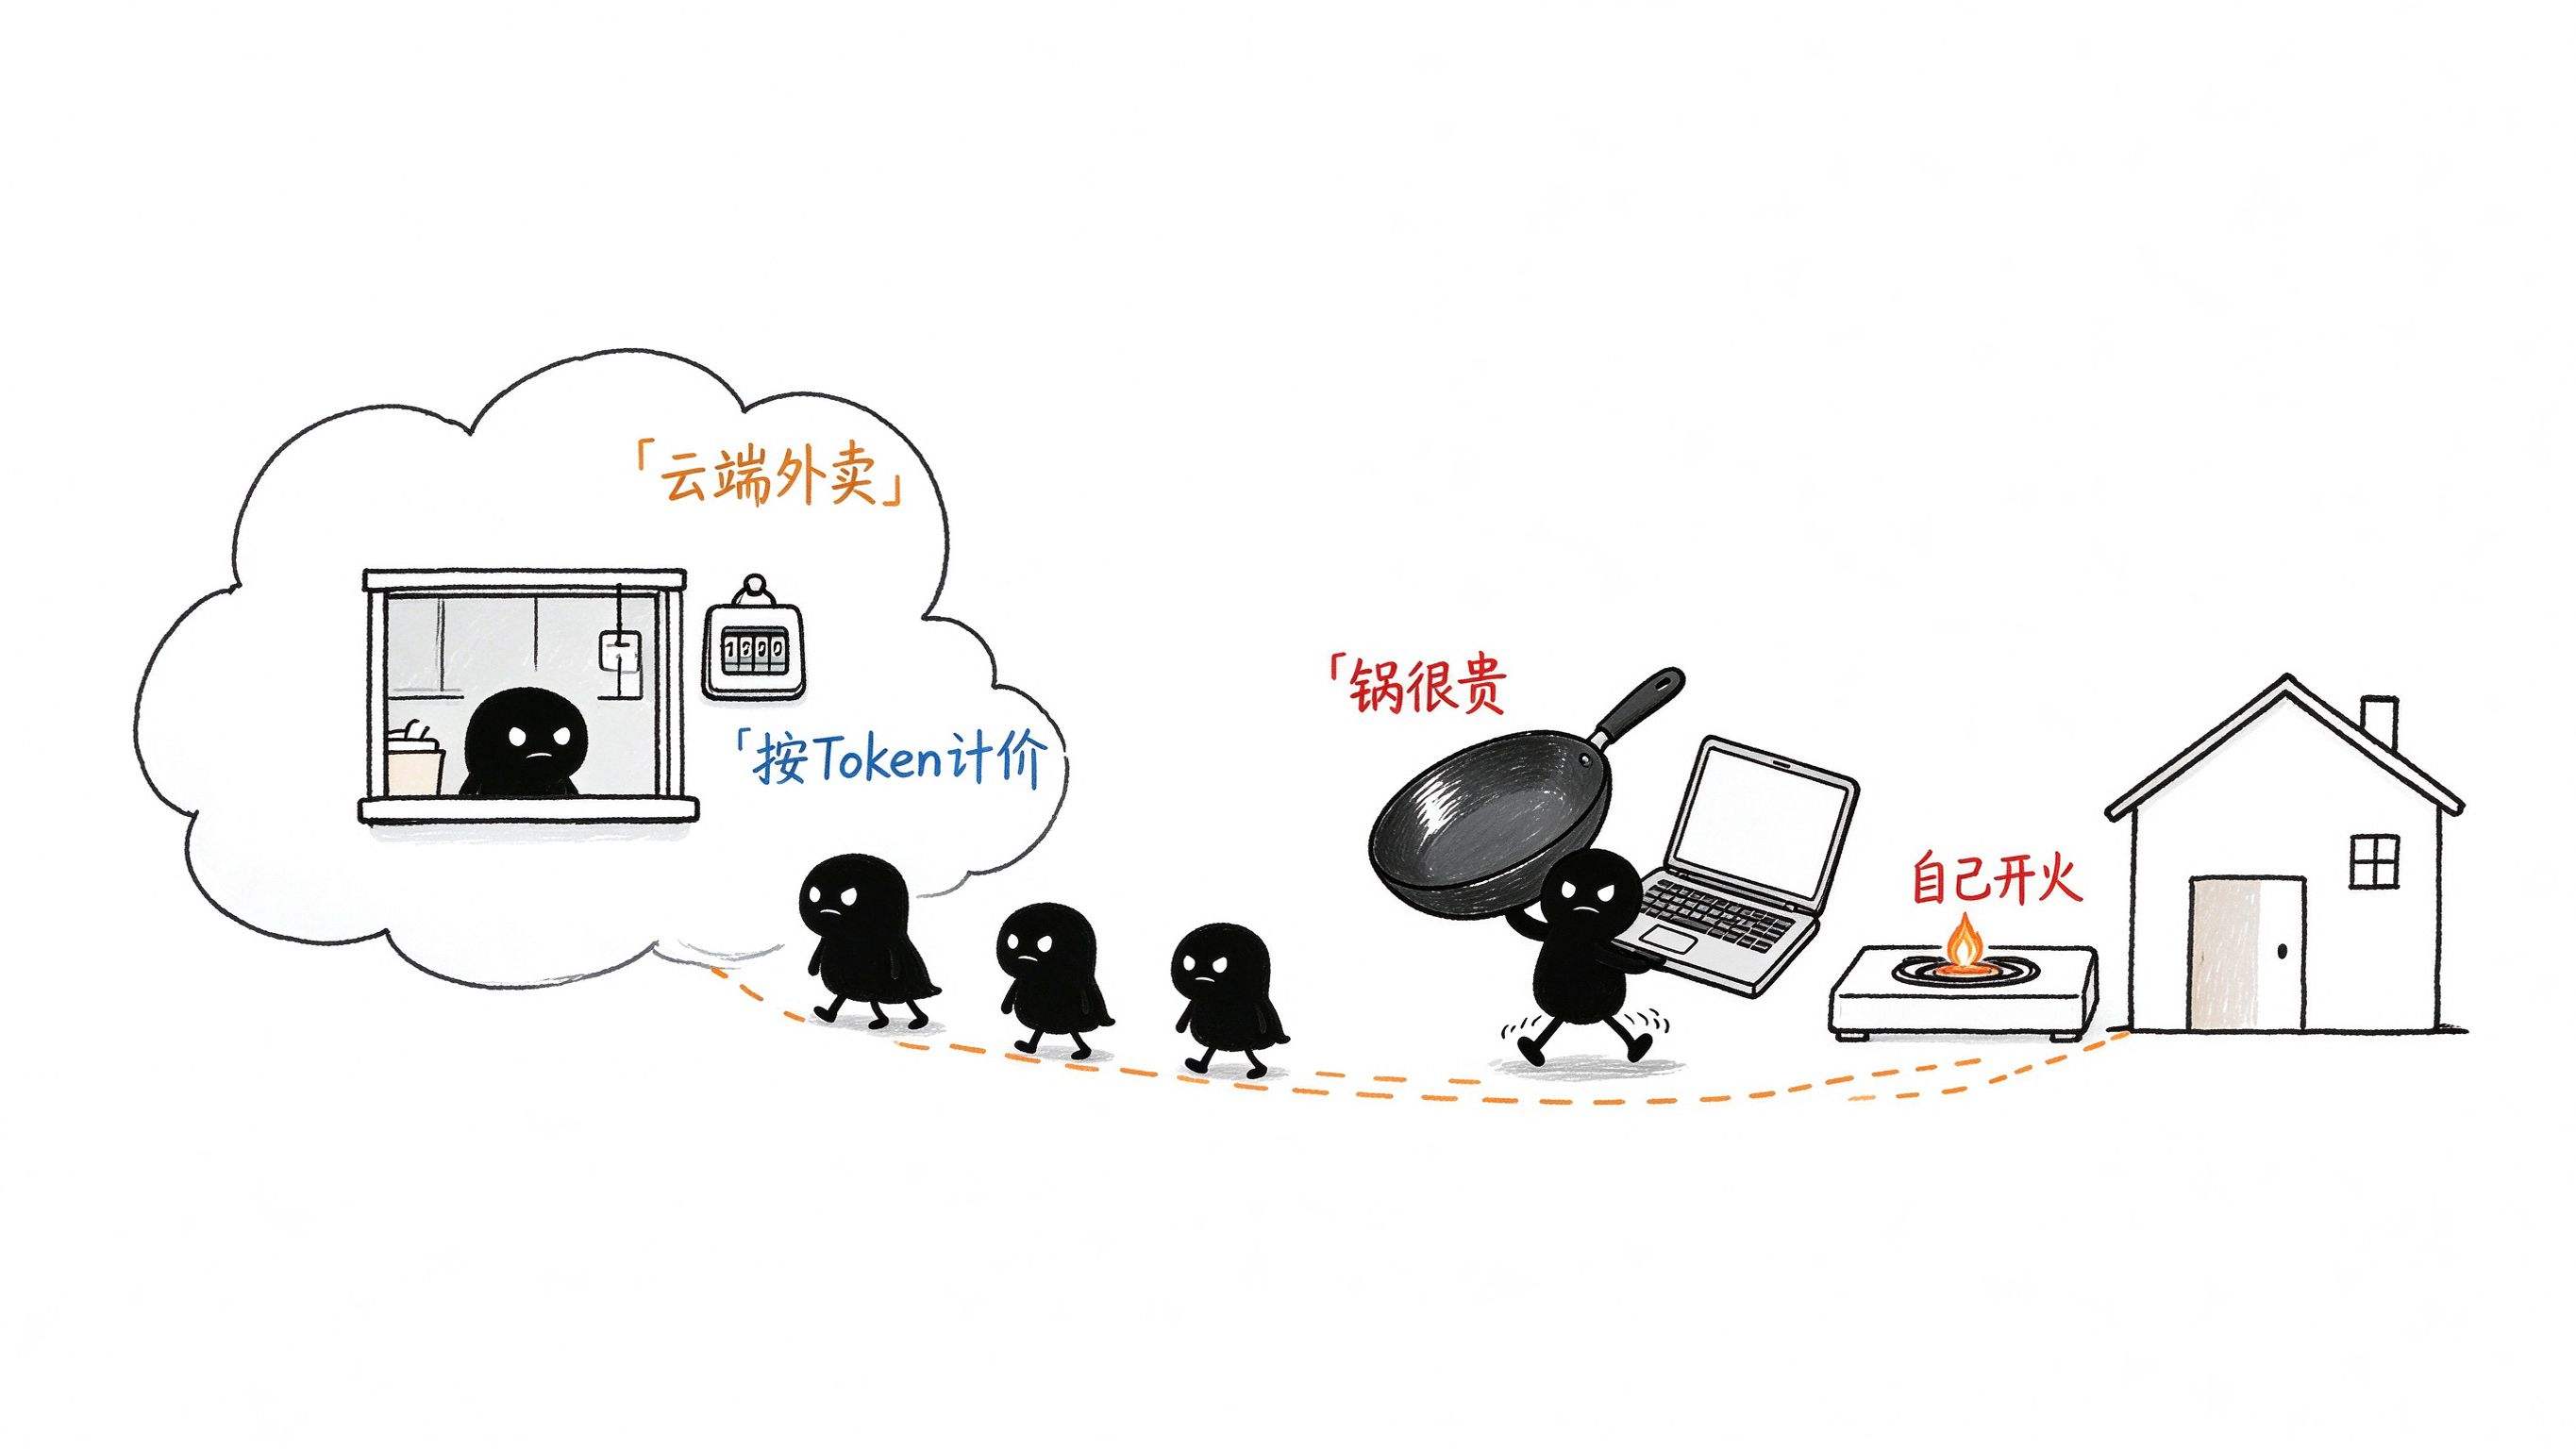
打个比方,云端模型是外卖,这台电脑卖的是一口能自己开火的锅。
先把这台机器交代清楚。按英伟达官方的说法,RTX Spark 是一颗把 Blackwell 显卡和 Grace CPU 塞在一起的超级芯片,最高 128GB 统一内存,1 petaflop 的 FP4 AI 算力,华硕、戴尔、惠普、联想、微软、微星都出了机器,美国起价 2599 美元。官方宣传的卖点,是在一台轻薄本上跑本地大模型和本地 Agent,Hermes、OpenClaw 这些 Agent 有引导安装,不用敲命令行。
懂行的朋友可能要说了,本地跑大模型,这事儿 Mac 早就能干了。
对,确实。苹果的统一内存很牛,Mac Studio 堆到大内存,跑个几十 B 的模型没问题。但卡兹克在文章里讲了一个很实在的痛点,很多 AI 项目底层都是围着英伟达的 CUDA 写的,到了 Mac 上就得各种移植和适配。想用 CUDA 呢,就得买英伟达显卡,可 5090 的显存才 32G,稍微大一点的模型就塞不进去。
**想要大内存就没有 CUDA,想要 CUDA 就没有大内存。**RTX Spark 把这两件事捏到了一起,所以对一部分人来说,它几乎是唯一解。
这是表面上的原因。更深的原因,藏在卡兹克那篇文章里算的一笔账。
他说他每个月光 AI 会员订阅就要 6000 块,还没算 API。他自己做的 AIHOT,每天后台处理上千条新闻,每条新闻背后三四个模型轮流干活,预筛、抽实体、打分、翻译、摘要、去重,最狠的时候 API 账单吓人,稳定下来以后每天还是 100 多块,而且用的已经全是 flash 级的小模型了。
你想想看,这还只是一个产品。
这就是我说的那口锅。云端模型像外卖,菜做得好,随叫随到,可每一口都要钱,吃得越多,账单越长。本地模型像自己家的厨房,锅很贵,买回来那一刻肉疼,可之后每顿饭的边际成本,几乎就是电费。
三万八的机器,对重度用户来说已经值得认真算一算。但每月 6000 元的订阅,不能全当成买了电脑就能省下的钱。云端最强模型仍然有用,回本要多久,得看有多少任务真能搬到本地。
这里得替云端说句公道话。
如果你只是每天问几个问题,改几封邮件,那三万八买一台本地机器,纯属给自己找罪受。云端模型的能力天花板,本地机器在可预见的时间里都追不上。最强的模型,永远在数据中心里,这一点我不觉得会变。
真正值得算的,是那些不需要最强模型、却要反复调用的后台任务。
这类任务搬到本地,才可能省下持续累积的 API 费用。
卡兹克举了一个特别好的例子。他英语不太好,看国外网站一直用付费的翻译插件。有了这台机器以后,他找了一个 2B 的翻译小模型部署在本地,自己搓了个 Chrome 插件,花了半小时,6 路并行,近乎实时翻译。他说这种需求以前基本不敢用 API 做,因为真的很烧钱。
我看到这里,脑子嗡了一下。
很多活,根本用不着最聪明的模型,只是需要一个永远在线、不收钱的模型。
翻译一段网页,识别一下屏幕上的内容,整理一下文件名,判断一下这封邮件要不要提醒你,每一件的计算量都很小,但如果它们一天发生几千次,每一次都要请求几千公里外的数据中心,每一次都按 Token 计费,这个账就没法算了。
这让我想起拍照。
胶卷时代,每按一次快门都要钱,所以大家拍照都很郑重,一卷 36 张,旅游一趟拍不完。后来数码相机出来,按快门的成本几乎是零,于是有了自拍,有了随手拍,再后来有了短视频。卡兹克在文章里也提到了这个类比,我很认同。拍照不要钱了以后,人们才开始拍那些以前根本不值得拍的东西。
AI 也一样。智能什么时候不按次收费了,人们才会把它用到那些以前根本不值得用智能的地方。
不过,夸到这里得踩个刹车了,这口锅也有它的毛病。
卡兹克做了一张对比表,RTX Spark 的内存带宽大约 300GB/s,桌面版 5090 是 1792GB/s,差了五六倍。算力也是,RTX Spark 的芯片功耗压到了 80W 左右,5090 单卡就要 575W。英伟达为了把它塞进一台轻薄本,压低了带宽和算力,换来了大内存和低功耗。
所以这口锅很大,能装下一整头鲸鱼,可是给锅供水的,是一根细水管。
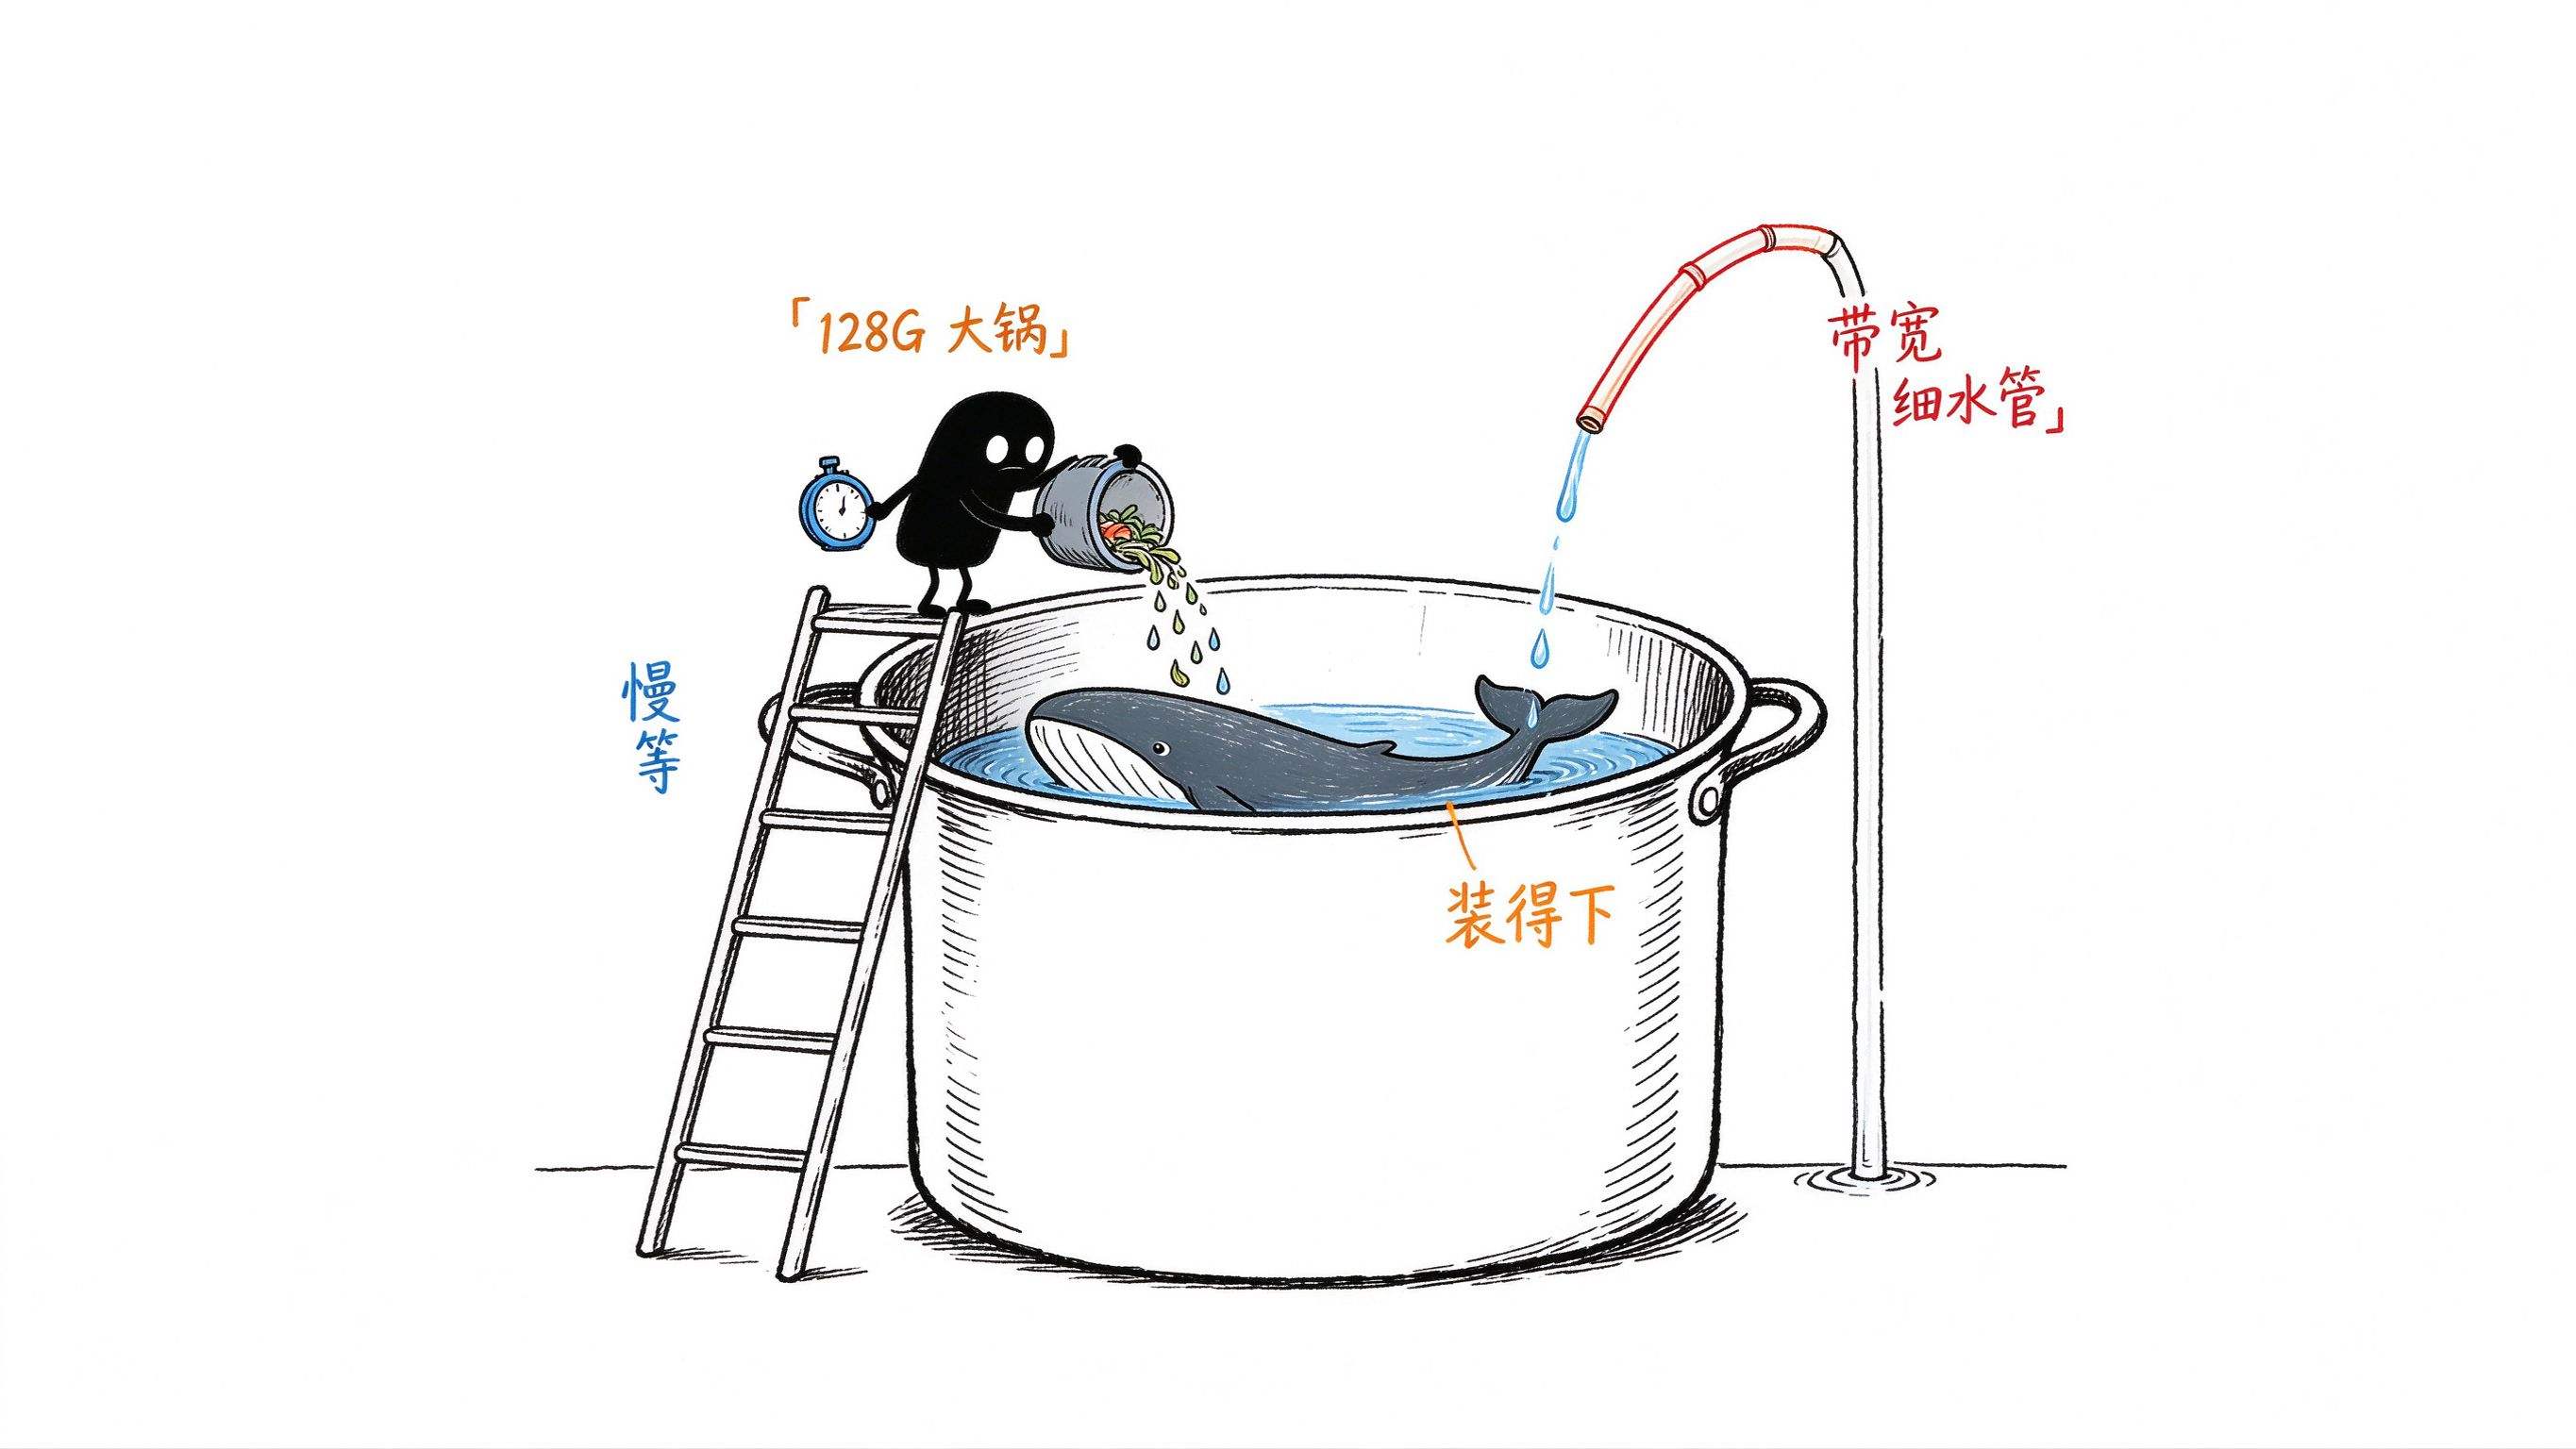
具体到速度上,卡兹克的实测是,WorkBuddy 里预设的本地模型能跑到 80 Token 每秒,换成他最推荐的 Qwen3.8-27B,开了 MTP 之后大约 30 Token 每秒。一张 1K 左右的图,Qwen-Image-2.1 大概一分多钟;15 秒的 720P 视频,本地要跑 20 分钟左右。
二十分钟一个视频。。。
128G 内存理论上能塞下 100B 左右的 Q4 量化模型,但他自己也说,不建议跑这么满。你装得下,不代表你跑得快。
这里我得说清楚,这些速度都是卡兹克一个人、一台机器、他自己的配置测出来的,换个模型、换个量化、换个推理引擎,数字都会变。另外他这台机器是英伟达寄的,他也写了感谢英伟达,看的时候心里有个数。我自己还没上手,没法给你更多一手体验。
英伟达这次显然也想到了另一个问题,Agent 在你自己电脑上跑,权限给多大?官方配了一个叫 OpenShell 的安全运行时,再加上微软的执行容器,专门管 Agent 能碰什么、不能碰什么。还专门出了一个 Nemotron 3.5 Bolt 74B-A9B 的模型,740 亿参数,每次只激活 90 亿,压到 24GB,主打工具调用和多步任务。锅之外,连锅盖和灶台的防火罩都配好了。
说实话,这一点我比速度更在意。云端模型出了错,最多是回答错了;本地 Agent 出了错,它手边就是你的硬盘、你的代码库、你的聊天记录。厨房搬回家,煤气也一起搬回来了。
所以这台机器到底适合谁?
我寻思了一下,大概是三种人。一种是 API 账单已经让他肉疼的重度用户,后台跑着一堆自动化。一种是数据不想出本地的人,代码、合同、病历、私人笔记。还有一种,就是纯粹爱折腾,想把一堆开源模型串起来玩的人,OCR 识别完交给翻译模型,翻译完再交给大模型整理,128G 内存的好处就是这几个模型可以同时挂着。
如果你不是这三种人,我真心建议你先别冲。三万八,够你买好几年的会员了。
再回到开头那台三万八的笔记本。
它给重度用户多了一个选择。适合云端的活继续叫外卖,适合本地的活,可以自己开火。虽然它贵,虽然它慢,虽然锅大水管细,但现在能把这口锅搬回家了。
而且它会变便宜。英伟达自己的路线图里,下一代芯片明年下半年就要来了。几十年前个人电脑刚出来的时候也贵得离谱,后来芯片越来越便宜,才慢慢变成了家家都有的东西。
今天三万八能买到的,是在本地舒服地跑一个几十 B 的模型。再过两年,类似的能力,也许就在一台普通笔记本、甚至一部手机里了。
到那时候,云端还是会在,最好吃的菜还是在餐厅。
只是我们终于可以在家里,给自己做一顿不用看账单的饭了。
谢谢你看我的文章,我们,下次再见。
/ 作者:青玉白露
评论区
欢迎留下你的看法,支持匿名评论。
你的评论会公开展示,建议填写便于交流的昵称,并尽量提供有信息量的反馈。